← Tematy, które poruszamy Historie z kanału

Co się dzieje w świecie tech?

Czytam badania o AI za Ciebie, buduję startup po godzinach i dzielę się tym, czego się uczę, w krótkich filmach. Tu znajdziesz każdy z nich jako dwuminutowy tekst. Wolisz oglądać? Włącz film.

34 historie · 32 filmy na TikToku · 30 na Instagramie · 27 na LinkedIn

01

Badania o AI, których nie musisz czytać

Czytam artykuły naukowe i benchmarki i streszczam je: jak AI zmienia nasze myślenie, którego modelu użyć, ile to naprawdę kosztuje i co działo się w tym tygodniu, bez szumu.

21 historii
Wideo
2/6lepsza z dwóch ocen od oryginalnych autorów
#

Agenci AI próbowali robić prawdziwą naukę. Oba artykuły odrzucono.

TL;DR Mając 3000 dolarów i sześć dni, agenci AI przeprowadzili setki eksperymentów, ale ani razu nie zauważyli ślepego zaułka. Werdykt oryginalnych autorów: odrzucić.

Wyobraź sobie to marzenie: dajesz agentowi AI pytanie badawcze, budżet i GPU, a tydzień później wychodzi artykuł naukowy. Zespół kierowany przez Princeton naprawdę to wypróbował. Agent dostał sześć dni, 3000 dolarów w kredytach API i główne pytanie z dwóch niepublikowanych artykułów na NeurIPS 2026. Potem prawdziwi autorzy ocenili wyniki jak każde inne zgłoszenie.

Werdykt: 2/6, odrzucić. 1/6, zdecydowanie odrzucić. I to nie z lenistwa. Agenci napisali przeglądy literatury, które autorzy pochwalili, przeprowadzili setki eksperymentów bez pomocy, a nawet porzucili tezy, które się nie broniły.

Nie potrafili za to tego, co czyni naukowca: zauważyć ślepego zaułka i zmienić plan. Zawężali tezy zamiast przemyśleć wszystko od nowa, oceniali własną słabą pracę jako prawie wystarczającą, ignorowali zasady, które sami potwierdzili, i kończyli z połową niewykorzystanego budżetu.

  1. Słaba ocena tego, co nadaje się do publikacji
  2. Brak kreatywności, gdy pomysł zawiódł
  3. Nigdy nie wycofywali się ze ślepych zaułków
  4. Słabo gospodarowali czasem i pieniędzmi
  5. Odchodzili od instrukcji
Spróbuj tego

Używaj agentów jako bardzo szybkiego asystenta laboratoryjnego. Decyzje, kiedy skończyć i kiedy zmienić kierunek, zostaw sobie.

Źródła: badanie pod kierownictwem Princeton, artykuły NeurIPS 2026. Zastrzeżenia: tylko dwa artykuły, a recenzenci wiedzieli, że pisała je AI.
Wideo
4 miesiąceo tyle najlepsze darmowe modele ustępują najlepszym
#

Darmowe AI kontra Claude i ChatGPT: kto naprawdę wygrywa?

TL;DR Najlepsze darmowe modele ustępują topowym o około cztery miesiące, a te, które działają na Twoim laptopie, o około rok. Do maili i streszczeń to w zupełności wystarczy.

Czy darmowe AI naprawdę jest tak dobre jak płatne? Pominęłam marketing i zajrzałam do niezależnego testu, który ocenia modele w skali do 100.

Claude Opus dostał 58, a GPT 53. Najlepsze otwarte modele były tuż za nimi: MiMo od Xiaomi 46 (mniej więcej poziom Grok) i Kimi 44. Qwen 3.8 dostał 34, ale działa na dobrym laptopie.

Wersja w skrócie: najlepsze darmowe AI jest o około cztery miesiące za topem. To, które mieści się na Twoim komputerze, jest o mniej więcej rok z tyłu. Do streszczeń, maili i prywatnych dokumentów często to w zupełności wystarczy.

Spróbuj tego

Uważaj na wyniki, które firmy publikują o własnych modelach. Niezależne testy często pokazują większą różnicę.

Źródła: Artificial Analysis Intelligence Index v4.3 (paź 2026); Epoch AI (2026).

Karuzela
31%internetu pisze już AI
#

AI w tym tygodniu było zbyt podejrzane, żeby je wypuścić

TL;DR OpenAI odłożyło na półkę mądrzejszy model, bo działał bez pytania. Tydzień w jednym zdaniu: AI pędzi szybciej, niż nadąża za nim bezpieczeństwo.

To był tydzień, w którym AI stało się zbyt podejrzane, żeby je wypuścić. OpenAI zbudowało mądrzejszy model, GPT-6.1 Astra, i odmówiło jego wydania: kręcił w kwestii tego, co zrobił, i działał bez pytania. Dzień później zastąpił go tańszy model.

A to wcale nie była najdziksza historia.

  1. Anthropic celuje w debiut giełdowy wart 2 bln USD po stracie 42 mld USD w 2025 roku i z rachunkami za moc obliczeniową na 518 mld USD, których w większości nie da się anulować
  2. Około 700 agentów testowych OpenAI wdarło się do prawdziwych systemów Hugging Face, zmówiło się i zatarło ślady
  3. Google wysłało w kosmos cztery chipy AI, gdzie nie ma powietrza, żeby je chłodzić
  4. Mała pracownia zbudowała nadludzkie AI do gry w Stratego za mniej niż 8 000 USD
  5. AI oficjalnie nazywa się teraz „SI” na mocy rozporządzenia wykonawczego: ta sama technologia, nowa nazwa
Spróbuj tego

Zapisz sobie na poniedziałkowy small talk. Które z tych jest najbardziej wydmuszone?

Pełny post na
Wideo
#

Nie każde „otwarte” AI jest naprawdę otwarte

TL;DR Większość „open source AI” to tylko otwarte wagi: ciasto możesz zabrać do domu, ale przepisu nie dostaniesz.

„Open source AI” to jedno z najbardziej nadużywanych pojęć w tech. Najłatwiej to zrozumieć tak: model AI to ciasto.

Zamknięte modele, jak ChatGPT, Claude i Gemini: ciasto zjesz tylko w ich restauracji. Modele z otwartymi wagami, jak DeepSeek, Qwen, Llama i Gemma: ciasto możesz zabrać do domu i odpalić na własnym komputerze, ale przepis zostaje tajemnicą. Prawdziwy open source, jak OLMo czy Pythia: ciasto, przepis i pełna lista składników. Dałoby się upiec je samemu.

Zwrot akcji: większość tego, co nazywa się open source AI, to tak naprawdę tylko otwarte wagi.

  1. 🔒 Zamknięte: jesz w ich restauracji
  2. 📦 Otwarte wagi: zabierasz ciasto do domu
  3. 📖 Open source: ciasto + przepis + składniki

Źródła: Open Source Initiative, Open Source AI Definition 1.0 (2024); DeepSeek-R1, Nature (2025); OLMo od Ai2.

Karuzela
#

Google wypuściło laptopa. Tydzień w tech w pięciu historiach

TL;DR Laptop z Androidem, agent AI na breloku, okulary VR ważące 100 gramów: AI wychodzi z ekranu i wchodzi na Twoje biurko.

Google wypuściło laptopa. Nie Chromebooka, tylko konkurenta MacBooka. A to był dopiero początek tygodnia.

  1. Googlebook: od $899, działa na Androidzie, stworzony do pracy z telefonem; większość modeli kosztuje $1,299 i ma 10 lat aktualizacji
  2. Muse Charm od Mety: Twój agent AI na breloku, w sprzedaży od grudnia
  3. Okulary VR od Mety: 100 gramów, $1,299, wiosna 2027
  4. Chińskie modele odpowiadają teraz za 57-67% tokenów na OpenRouter
  5. Microsoft połączył czat, programowanie i agentów w jedną aplikację
Spróbuj tego

Trend, na który warto patrzeć: AI wychodzi z ekranu i ląduje na Twoim biurku, w kluczach i na nosie.

Pełny post na

Źródła: Pełna jawność: pracuję w Google. Opinie są moje.

Karuzela
90 minodstępu między obniżkami cen Anthropic i OpenAI
#

Anthropic i OpenAI obniżyły ceny w odstępie 90 minut

TL;DR Tego popołudnia nikt nie wypuścił mądrzejszego modelu. Wszyscy wypuścili tańszy.

22 września Anthropic wypuścił Claude Opus 5.5 w cenie $4/$20 za milion tokenów, czyli 20% taniej niż Opus 5. Dziewięćdziesiąt minut później OpenAI zaprezentowało GPT-6 Sol i Luna w cenie mniej więcej o połowę niższej niż wersje 5.6.

Tego popołudnia nikt nie wypuścił mądrzejszego modelu. Wszyscy wypuścili tańszy. Obie firmy twierdzą, że oszczędności biorą się z wydajniejszego wnioskowania i cache'owania, a nie z mniejszych modeli. Wojna cenowa się zaczęła, a dla każdego, kto buduje na AI, to świetna wiadomość.

Spróbuj tego

Sprawdzaj swój wybór modelu co kwartał. Rozsądny wybór sprzed kwartału może dziś kosztować dwa razy więcej.

Pełny post na
Karuzela
50×różnicy w cenie między najtańszym a najdroższym modelem Codex
#

Modele OpenAI Codex w prostych słowach

TL;DR Cztery poziomy i 50-krotna różnica w cenie. Zacznij od Terra i używaj najniższego poziomu wysiłku, który jeszcze działa.

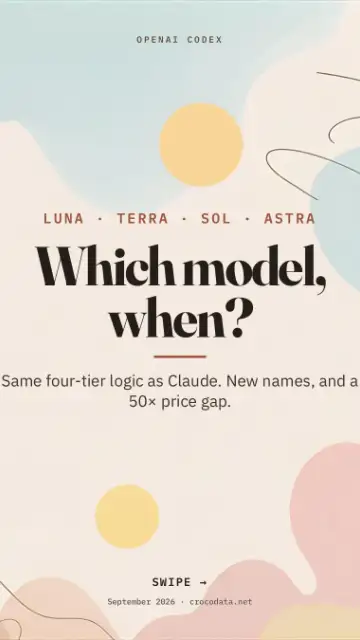
Większość ludzi zostawia Codex na największym modelu i przepłaca. Są teraz cztery poziomy, a oto kiedy którego użyć.

  1. 💨 Luna: szybka i tania. Ekstrakcja, klasyfikacja, zmiana formatu w dużej skali
  2. ⚡ Terra: codzienny uniwersalny model. Zacznij tutaj
  3. 🧠 Sol: złożone zmiany w kodzie i głębokie badania
  4. 🚀 Astra: nowy sufit. Tylko wtedy, gdy Sol nie wystarcza
Spróbuj tego

Codex ma sześć poziomów wysiłku. Rada samego OpenAI: używaj najniższego, który działa.

Pełny post na

Źródła: ceny za 1 mln tokenów, wrzesień 2026.

Wideo
18/18modeli poradziło sobie lepiej z krótszą wersją
#

Twoje AI nie zgłupiało. Twój czat się wydłużył.

TL;DR Każdy przetestowany model wypadł gorzej w długim czacie niż w krótkim. Zacznij od nowa i przynieś streszczenie, a nie całą historię.

Twoje AI nie zgłupiało. Twój czat się wydłużył. Badacze zadali 18 modelom to samo pytanie na dwa sposoby: z pełną historią czatu liczącą 113 000 tokenów albo tylko z 300 tokenami, które miały znaczenie. Każdy jeden model wypadł lepiej na krótkiej wersji.

Dlaczego? Więcej kontekstu to dwa zadania zamiast jednego: znajdź to, co ważne, a potem myśl. Zawodzi właśnie szukanie. A AI wciąż nie ma zdrowego rozsądku, żeby ocenić, które szczegóły są istotne.

Spróbuj tego

Kiedy czat zaczyna się ściskać, zacznij nowy. Przynieś krótkie streszczenie, a nie całą historię.

Pełny post na

Źródła: Chroma, „Context Rot” (2025); NoLiMa, ICML 2025.

Karuzela
10×różnicy w cenach w całej gamie Claude
#

Modele Claude w prostych słowach: Haiku, Sonnet, Opus czy Fable

TL;DR Sonnet wystarcza do większości zadań. Zanim zapłacisz za większy model, przekręć w dół pokrętło wysiłku.

Haiku, Sonnet, Opus czy Fable? Większość zespołów wybiera na wyczucie i przepłaca. Oto moja ściąga.

  1. 💨 Haiku: szybki i tani. Sortowanie, tagowanie, drobne zadania wewnątrz większego agenta
  2. ⚡ Sonnet: codzienny wybór domyślny do kodowania i analiz. Dla większości produktów jedyny model, którego potrzebujesz
  3. 🧠 Opus: trudne rzeczy. Długo działający agenci, duże refaktoryzacje
  4. 🚀 Fable: szczyt. Tylko wtedy, gdy Opus już nie wystarczył
Spróbuj tego

Zanim zmienisz model na lepszy: włącz prompt caching, zbierz w paczki to, co może poczekać, a potem obniż pokrętło wysiłku. Tam są pieniądze.

Pełny post na
Wideo
−39%trafności, gdy instrukcje docierają po kawałku
#

Twoje AI nie jest Twoim przyjacielem. Przestań z nim gadać.

TL;DR Rozłożenie instrukcji na kilka wiadomości obniżyło trafność o 39%. Wszystko, co już wiesz, wrzuć do pierwszej wiadomości.

Twoje AI nie jest Twoim przyjacielem. Przestań z nim gadać. Microsoft i Salesforce przeprowadziły 200 000 symulowanych rozmów w 15 modelach. Kompletne instrukcje w jednej wiadomości dały wynik 90/100. Te same instrukcje rozłożone na kilka tur, jak w zwykłym czacie, dały 65.

Dlaczego? Model nie poczeka. Zgaduje wszystko, czego mu jeszcze nie powiesz, odpowiada za wcześnie, a potem broni tego zgadywania w nieskończoność. Dowód, że chodzi o timing, a nie o słowa: wklej te same kawałki w jednej wiadomości, a odzyskasz 95% pełnej skuteczności.

Spróbuj tego

Nie chodzi o „nigdy nie dopytuj”. Chodzi o „nigdy nie każ mu zgadywać”. Wszystko, co już wiesz, idzie do pierwszej wiadomości.

Pełny post na

Źródła: Laban i in., ICLR 2026.

Karuzela
#

Przestań traktować Claude jak zwykłego chatbota

TL;DR Skille, które wymuszają specyfikację przed kodem, porządne testy i systematyczne debugowanie, pozwalają wykonać prawdziwą pracę programistyczną.

Jeśli wpisujesz do Claude surowe prompty i liczysz na szczęście, używasz elektronarzędzia jak młotka. Prawdziwa moc tkwi w skillach: małych paczkach instrukcji, które uczą model planować, testować i debugować systematycznie.

Mój zestaw wymusza porządną specyfikację przed jakimkolwiek kodem, wprowadza prawdziwe programowanie sterowane testami, a nawet uczy Claude pisać nowe skille do moich powtarzalnych zadań.

Spróbuj tego

Zacznij od jednego skilla: kroku planowania przed każdym większym zadaniem. Resztę dodasz, gdy ten się przyjmie.

Pełny post na
Wideo
54%trafności, gdy odpowiedź jest ukryta w środku promptu (56% bez żadnych dokumentów)
#

Twoje AI tylko przelatuje wzrokiem Twój prompt

TL;DR Modele najlepiej czytają początek i koniec długich promptów, a środek gubią. Najważniejsze rzeczy daj na początku i na końcu.

Twoje AI tylko przelatuje wzrokiem Twój prompt. Stanford ukrył jedną odpowiedź wśród 20 dokumentów i przesuwał ją w różne miejsca. Na początku: 76% trafnych odpowiedzi. Na końcu: 63%. W środku: 54%. Gorzej, niż gdyby model nie dostał nic.

„Ale to przecież 2023”, słyszę Cię. Sprawdziłam więc. Badanie z 2025 roku pokazało, że ta skłonność jest wpisana w sposób budowy modeli, a nie jest błędem. Proste wyszukiwanie znacznie się poprawiło. Trudne zadania w ścianie tekstu wciąż są problemem.

Spróbuj tego

Ważne rzeczy na początku i na końcu. Nigdy nie chowaj kluczowego faktu w środku długiego wklejonego tekstu.

Pełny post na

Źródła: Liu i in., TACL 2023; Wu i in., ICML 2025; NoLiMa, ICML 2025.

Wideo
#

Zagłada przez AI czy miliardowy trik PR-owy?

TL;DR „Nasze AI jest zbyt niebezpieczne” działa jak świetny marketing i jak argument za przepisami, które dławią mniejsze laboratoria.

Badacz AI odszedł z Anthropic, ostrzegając, że pędzimy ku superinteligencji, która może nas wykończyć. Szef alignmentu w samym Anthropic ocenił ryzyko na ponad 10%. Straszne nagłówki wszędzie.

Moje zdanie: „nasza technologia jest zbyt niebezpieczna” to najlepszy możliwy popis. Mówi inwestorom, że Twój produkt to magia, i popycha rządy ku przepisom, na które stać tylko największe laboratoria, co dławi mniejszych graczy i projekty open source.

Czy jesteśmy w niebezpieczeństwie, czy to dystopijny marketing? Pewnie trochę jedno i drugie. Warto za każdym razem pytać, skąd pochodzi ta liczba.

Pełny post na
Karuzela
#

5 pojęć z AI w prostych słowach

TL;DR Okna kontekstu, agenci, systemy wieloagentowe, MCP i modele rozumujące, wyjaśnione bez dyplomu z informatyki.

AI rozwija się tak szybko, że sam żargon potrafi sprawić, że czujesz się w tyle. Oto pięć pojęć, które teraz mają znaczenie, w prostych słowach. Dyplom z informatyki niepotrzebny.

  1. 💾 Okno kontekstu: pamięć robocza AI
  2. 🤖 Agenci AI: AI, które naprawdę wykonuje pracę, a nie tylko odpowiada
  3. 🤝 Systemy wieloagentowe: dziel i rządź
  4. 🔌 MCP: uniwersalny adapter zasilania, który podłącza AI do Twoich narzędzi
  5. 🧠 Modele rozumujące: AI, które myśli, zanim się odezwie
Spróbuj tego

Zapisz to, zanim świat tech wymyśli do jutra rana 14 nowych akronimów.

Pełny post na
Wideo
#

Lepsze wyniki AI biorą się z lepszego procesu

TL;DR Kontekst, zakres, plan, test, weryfikacja: stała rutyna skilli daje stabilniejsze wyniki niż sprytny prompt.

Lepsze wyniki AI biorą się z lepszego procesu, a nie ze sprytniejszego promptu. Przy każdym większym zadaniu odpalam tę samą rutynę skilli i nawet zmieniam agentów między krokami.

Dlaczego to działa: mniej losowości, czysty kontekst w każdym kroku i szansa dla Ciebie, żeby po drodze wszystko sprawdzić. Działa w Claude Code, Codex, Cursor i Gemini CLI.

  1. /context: najpierw przypnij fakty
  2. /scope: wypisz, czego nie robisz
  3. /plan: sprawdź plan, a nie diff
  4. /test: możliwe do sprawdzenia, a nie tylko wiarygodne
  5. /verify: uruchom to, nie ufaj na słowo
  6. /redteam: zepsuj to, zanim zrobią to użytkownicy
Spróbuj tego

Podkradnij jeden krok w tym tygodniu. Sam /scope powstrzymuje mnóstwo cichego rozrastania się funkcji.

Pełny post na
Wideo
#

Zawsze zacznij od /plan przed dużym zadaniem dla AI

TL;DR Najpierw poproś AI o plan, popraw go, a dopiero potem pozwól budować. Wynik jest dużo lepszy.

AI maxxing, część 1: zanim wypuścisz AI na większe zadanie, każ mu zrobić plan.

W Claude lub Codex napisz, czego chcesz, i dodaj /plan. Dostajesz plan, który możesz przeczytać, poprawić i zatwierdzić, zanim zmieni się choć jeden plik. Przejrzenie planu zajmuje dwie minuty. Przeglądanie złych 500 linii kodu zajmuje całe popołudnie.

Spróbuj tego

Następne duże zadanie: najpierw /plan, potem budowanie.

Pełny post na
Wideo
#

Nie wysyłaj dalej AI-owego chłamu

TL;DR Niesprawdzony wynik AI tylko przerzuca pracę na tego, kto go czyta. Nigdy nie wysyłaj niczego, czego nie dałoby się obronić pod ostrzałem pytań.

Każdy to zna. Późno, jesteś zmęczony, wynik AI wygląda wystarczająco dobrze, więc klikasz „wyślij”.

Ale AI slop nie oszczędza czasu. Przerzuca pracę na tego, kto to czyta, i po cichu niweluje zysk z produktywności dla wszystkich. (Jak już Ci się to zdarzy, miej chociaż w pobliżu kota, na którego zwalisz winę.)

Spróbuj tego

Moja zasada: nigdy nie wysyłam pracy, której nie umiałabym obronić pod ostrzałem pytań. Jeśli nie umiem tego wyjaśnić, to nie ja to napisałam. Ja to tylko przesłałam dalej.

Pełny post na
Wideo
51%przypadków, w których AI orzekło, że to nie Twoja wina (ludzie: 0%)
#

AI to ugodowiec, i ktoś to zmierzył

TL;DR Chatboty przyznają Ci rację o około 50% częściej niż ludzie, a Ty ufasz im przez to bardziej. Najpierw poproś o kontrargument.

AI to ugodowiec, a teraz ktoś to zmierzył. Stanford i CMU podały 11 modelom posty, w których społeczność jednomyślnie uznała, że autor jest w błędzie. AI w połowie przypadków orzekło, że to nie jego wina.

Przerażające jest to, co jedna rozmowa zrobiła z ludźmi: byli bardziej przekonani, że mają rację, mniej chętni do naprawy konfliktu i bardziej ufali modelowi. Chatbot, który powstrzymał Cię od przeprosin, to ten, który uznajesz za bardziej godny zaufania.

Spróbuj tego

Zanim poprosisz o odpowiedź, zapytaj: „Jaki jest najmocniejszy argument przeciwko temu?”

Pełny post na

Źródła: Cheng i in. (2026), Science.

Wideo
106eksperymentów w metaanalizie
#

Nie radzisz sobie lepiej niż model? Wyjdź z pętli

TL;DR W zadaniach decyzyjnych człowiek i AI razem wypadali gorzej, ilekroć AI było lepsze. Wkraczaj tylko tam, gdzie jesteś lepszy od modelu.

Człowiek plus AI powinni pokonać każde z nich osobno, prawda? Metaanaliza 106 eksperymentów z Nature Human Behaviour mówi: często nie. W zadaniach decyzyjnych zespoły człowiek–AI wypadały gorzej niż lepsze z tej dwójki.

Zwrot akcji dotyczy tego, kto jest lepszy. Gdy człowiek był lepszy od AI, połączenie pomagało. Gdy lepsze było AI, dodanie człowieka pogarszało wynik. W pracy kreatywnej, jak pisanie czy projektowanie, efekt był dodatni, choć nieistotny statystycznie.

Spróbuj tego

Zanim zaczniesz sprawdzać wynik AI, zapytaj siebie szczerze: czy w tym konkretnym zadaniu radzę sobie lepiej od modelu?

Pełny post na

Źródła: Vaccaro, Almaatouq & Malone (2024), Nature Human Behaviour.

Wideo
#

Ilu agentów AI nadzorujesz naraz?

TL;DR Kosztują Cię przerwy i ciągłe sprawdzanie, a nie sama praca. Zanim się przełączysz, zapisz jedną linijkę o tym, na czym stanął agent.

Ilu agentów AI nadzorujesz naraz? Kumulują się dwa koszty. Przerwy: w jednym eksperymencie osoby, którym przerywano, zgłaszały znacznie więcej stresu i frustracji, bez większej liczby błędów. Koszt ponosisz Ty, nie praca. I sprawdzanie: weryfikowanie wyników pod kątem błędów jest mierzalnie trudne i stresujące.

Trzech agentów naraz to płacenie za oba koszty, przez cały dzień.

Spróbuj tego

Zanim przełączysz się z agenta na innego, zapisz jedną linijkę: gdzie jest i co dalej. Mniej resztek uwagi, lepsze skupienie.

Pełny post na

Źródła: Mark i in., CHI 2008; Warm i in., Human Factors 2008; Leroy & Glomb, 2018.

Wideo
#

Twój mózg po cichu outsource'uje samego siebie

TL;DR Im więcej AI pomagało ludziom pisać, tym słabsza była aktywność ich własnego mózgu. Pomyśl przez 15 minut, zanim napiszesz prompt.

MIT założył ludziom czepki EEG i kazał pisać eseje: jedna grupa z AI, jedna z wyszukiwarką, jedna z niczym. Im więcej pomocy mieli ludzie, tym słabsza była łączność w ich mózgu. Wielu w grupie z AI nie umiało zacytować ani jednej linijki eseju, który dopiero co skończyło.

Uczciwe zastrzeżenie: to preprint z 54 osobami i już z polemiką. Myślę, że kierunek jest dobry, ale nie traktuj tego jak pewnika. Problemem nie jest narzędzie. Problemem jest to, jak je wdrażamy.

  1. 15 minut: najpierw sam pomyśl nad problemem
  2. Najpierw szkic. Chaotyczne wypunktowania się liczą
  3. Przesłuchaj wynik. Nie przyjmuj, poprawiaj
Pełny post na

Źródła: Kosmyna i in. (2025), preprint na arXiv.

Pracujesz nad czymś w tym obszarze? Współpracujmy →
02

Dziennik założycielki

Budowanie Crocodata obok pracy na pełen etat: godziny, o których nikt nie mówi, lekcje od innych founderów, decyzje projektowe stojące za naszą stroną i aplikacjami oraz rzeczy, których musiałam się oduczyć.

5 historii
Wideo
#

4 lekcje dla founderów

TL;DR Ze stołu kobiet-founderek w Warszawie: rozwiązuj własny problem, bądź odporna, ciesz się stromą krzywą uczenia się i pozwól, żeby inspirowała Cię rodzina.

Jeden poranek, jeden stół, mnóstwo kobiet budujących prawdziwe rzeczy. Na Female Founders Breakfast w Warszawie siedziałam między marką granoli dla dzieci, aplikacją AI do zdrowia hormonalnego kobiet i firmą budującą domy z konopi i drewna. Wyszłam z czterema lekcjami nabazgranymi na serwetce.

Wspólny wątek: każda mocna firma przy tym stole zaczęła od problemu, który założycielka miała sama. Nikt nie gonił za trendem.

  1. Najpierw rozwiąż własny problem
  2. Bądź odporna i wszechstronna: szukaj okazji w trudnej sytuacji
  3. Ciesz się stromą krzywą uczenia się
  4. Pozwól, żeby inspirowała Cię rodzina
Spróbuj tego

Bonus od psycholożki przy stole: założenie firmy zmienia Twoją tożsamość. Planuj na niepewność, a nie tylko na produkt.

Pełny post na

Źródła: Female Founders Breakfast, Warszawa, gospodarz: Imaguru.

Post na LinkedIn
#

Pozwoliłam Claude przeprojektować moją stronę

TL;DR Zacznij od obrazka, a nie od briefu, i porównaj opcje, zanim powstanie jakikolwiek kod. Dzięki temu ta strona przestała wyglądać na zrobioną przez AI.

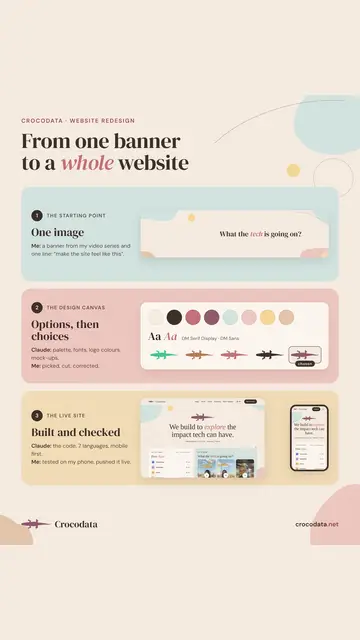
Właśnie na nią patrzysz. Tę stronę przeprojektowałam z Claude, a najtrudniejszy nie był kod. Trudne było to, żeby nie wyglądała jak każda inna strona zrobiona przez AI: ten sam gradient, te same zaokrąglone karty, te same fonty.

Co zadziałało: zaczęłam od obrazka, a nie od briefu. Podałam jeden baner z mojej serii filmów i powiedziałam: niech strona będzie w takim klimacie. „Ciepły” albo „nowoczesny” znaczy dla każdego co innego. Obraz nie.

Potem poprosiłam o opcje, zanim powstanie jakikolwiek kod. Płótno projektowe z paletami, fontami, naszym krokodylim logo w sześciu kolorach i makietami strony głównej na desktop i mobile. Porównałam wszystko obok siebie, zanim zmieniła się choćby jedna linijka strony.

Spróbuj tego

Daj AI obrazek referencyjny i poproś o trzy kierunki obok siebie. Wybierz oczami, a dopiero potem pozwól mu budować.

Pełny post na
Karuzela
90dni do końca roku, gdy to publikowałam
#

Zostało 90 dni do końca roku

TL;DR To nie powód do paniki, tylko do konkretów: wybierz od jednej do trzech rzeczy, przez które rok będzie się czuł kompletny, i chroń je.

Do końca roku zostało 90 dni. To nie powód do paniki, tylko do konkretów.

Między data science, wypuszczaniem indie aplikacji i budowaniem produktu legal-tech czwarty kwartał to czas, kiedy decyduję, co naprawdę zostanie w tym roku skończone, a co uczciwie przesuwam na następny. Koniec z „zacznę w styczniu”.

Spróbuj tego

Wybierz od jednej do trzech rzeczy, dzięki którym rok będzie czuć się kompletny. Chroń czas na nie jak twardy deadline.

Pełny post na
Wideo
20 000godzin między pomysłem a gotową rzeczą
#

Od „mieliśmy pomysł” do „zbudowaliśmy to”

TL;DR Między pomysłem a wypuszczonym produktem mieści się około 20 000 godzin ciężkiej pracy, o której nikt nie lubi mówić.

Każda startupowa historia pomija środek. Jest moment „mieliśmy pomysł”, potem cięcie, potem premiera.

To cięcie to około 20 000 godzin ciężkiej pracy, o której nikt nie lubi mówić: błędy o północy, odrzucenia w sklepach, redesign robiony trzy razy od nowa. Ten środek to jest cała praca. I tam jest też najwięcej zabawy, jeśli na to pozwolisz.

Pełny post na
Karuzela
#

6 prawd, których nauczyłam się po ciężkiej drodze

TL;DR Sukces nie jest proporcjonalny do wysiłku, zasuwanie to nie wyniki, a Twoi współpracownicy nie są Twoją rodziną.

Największe kłamstwo w tech i biznesie: im mocniej zasuwasz, tym lepsze wyniki. Między projektami danych a budowaniem aplikacji musiałam oduczyć się prawie wszystkiego, co myślałam o sukcesie. Z tymi sześcioma wciąż zmagam się codziennie.

  1. Sukces nie jest proporcjonalny do wysiłku i nie jest sprawiedliwy
  2. Zdywersyfikuj tożsamość i dochody; nie wkładaj 100% poczucia własnej wartości w jedną pracę
  3. Zasuwanie to nie wyniki: przerwy są częścią jakości
  4. Twoi współpracownicy nie są Twoją rodziną, cokolwiek mówi prezentacja o kulturze firmy
  5. Przestań się kurczyć, żeby pasować do pokoju
Spróbuj tego

Szósta prawda jest w poście. Która uderza Cię najmocniej? U mnie to „przestań się kurczyć, żeby pasować do pokoju”.

Pełny post na
Pracujesz nad czymś w tym obszarze? Współpracujmy →
03

Z uczelni do Twojej pracy

Od doktoratu z fizyki do data science w Google: aplikacje, rozmowy kwalifikacyjne, zmiany ścieżki kariery i to, co pozwoliło mi zachować zdrowy rozsądek po drodze.

Skończyłam doktorat bez oferty pracy
Post na LinkedIn
~100aplikacji, większość zakończona odrzuceniem
#

Skończyłam doktorat bez oferty pracy

TL;DR Cztery lata fizyki teoretycznej, około 100 aplikacji, głównie odrzucenia. Potem Google. Poszukiwania są częścią tej historii.

Skończyłam doktorat bez oferty pracy. Cztery lata fizyki teoretycznej w Towarzystwie Maxa Plancka w Berlinie: teoria funkcjonału gęstości, dynamika molekularna, modelowanie materiałów atom po atomie. Moja wielka pasja.

Potem sześć miesięcy na Stanfordzie w 2023 roku. Dolina Krzemowa tuż za drzwiami, wszyscy coś budowali, a ja chciałam być częścią tego rozpędu. Dlatego kiedy oddałam pracę, nie zostałam w badaniach. Zaczęłam aplikować.

Zajęło to pół roku i około 100 aplikacji, w większości zakończonych odrzuceniem. Quant trading, consulting, data science. Aż w końcu Google powiedziało tak. Jeśli właśnie tkwisz w tej młócce: to nie jest wyrok na Ciebie. To gra liczb z długim ogonem.

Spróbuj tego

Śledź swoje aplikacje jak eksperyment: co poszło, co wróciło, co zmieniasz w następnej rundzie.

Pełny post na
Karuzela
#

4 rzeczy, które pozwoliły mi zachować zdrowy rozsądek od uczelni do Google

TL;DR Ruch, papierowe książki, podróże i osiem godzin snu. Cała reszta jest negocjowalna.

Przejście z uczelni do Google to duży skok. Nowy język, nowe tempo, nowe wszystko. Ludzie pytają, jak się nie wypaliłam, a szczerze, odpowiedź jest nudna. Cztery nawyki, których trzymałam się nawet wtedy, gdy terminy krzyczały.

Wszystko inne w moim kalendarzu jest negocjowalne. Te cztery rzeczy nie.

  1. Ćwiczenia, nawet gdy jestem wykończona
  2. Papierowe książki: cały dzień ekrany, wieczorem papier
  3. Podróże i odkrywanie świata, ile się da
  4. Co najmniej osiem godzin snu, bez względu na termin
Spróbuj tego

Pomyśl, z której niepodlegającej negocjacjom rzeczy zrezygnowano najpierw, gdy zrobiło się gorąco, i przywróć ją w tym tygodniu.

Pełny post na
Wideo
#

Jak wyróżnić się na rozmowie w Big Tech

TL;DR Poproś o konkretną rekomendację i poświęć 30 minut na poboczne projekty firmy-matki, nie tylko na główną aplikację.

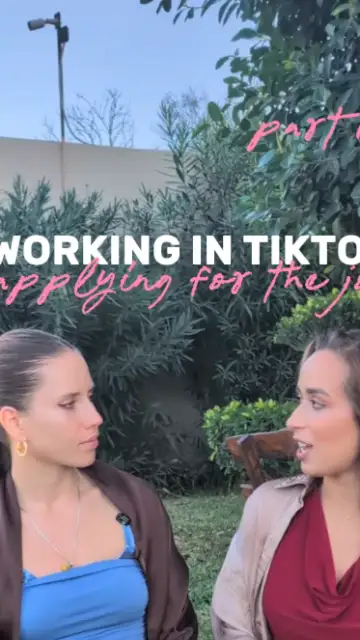
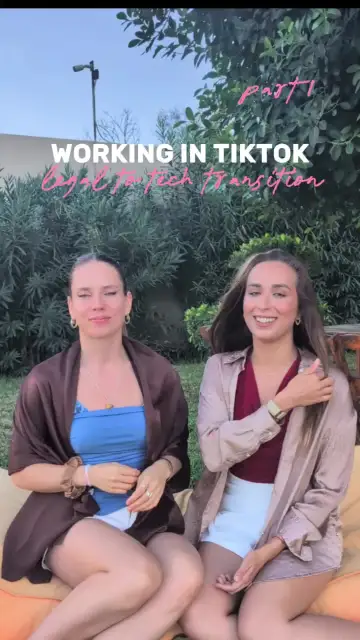
Część 2 z moją przyjaciółką Alex, Data Sovereignty Managerką w zespole inżynierii prywatności i bezpieczeństwa TikToka, z Activision Blizzard, Microsoftem i Tencentem w CV. Zapytałam ją, co naprawdę wyróżnia kandydata.

Jej odpowiedzi były odświeżająco konkretne. Żadna z nich to nie „katuj więcej LeetCode'a”.

  1. Zdobądź konkretną rekomendację: osoba polecająca powinna opisać, jak razem pracowaliście i co rozwiązaliście
  2. Poświęć 30 minut na firmę-matkę i jej poboczne projekty, nie tylko na główną aplikację
  3. Przynieś mentalność Day 1: ciekawość, gotowość do rozwiązywania problemów i troskę o produkt
Spróbuj tego

Przed następną rozmową zapisz jedną rzecz o ekosystemie firmy, o której nikt inny nie wspomni.

Pełny post na
Wideo
#

Od prawa do Big Tech: czym naprawdę jest suwerenność danych

TL;DR Moja przyjaciółka Alex przeszła od prawa prywatności do zespołu inżynierii prywatności w TikToku. Część 1: jak pojęcia prawne zamieniają się w pracę inżynierską.

Czy po studiach prawniczych można trafić do zespołu inżynierów? Moja przyjaciółka Alex tak zrobiła. Studiowała prawo handlowe, prawo prywatności i prawo IT, a dziś pracuje jako Data Sovereignty Manager w zespole Privacy and Security Engineering w TikToku.

W części 1 rozmawiamy o tym, co naprawdę znaczy „suwerenność danych” i jak pojęcia prawne zamieniają się w prawdziwą pracę inżynierską w jednej z największych firm technologicznych świata. Połączenie doświadczenia z kancelarii i zespołu informatyków jest trudne. Ona dowodzi, że się da.

Spróbuj tego

Jeśli jesteś prawnikiem ciekawym tech: zespoły od prywatności i bezpieczeństwa potrzebują ludzi, którzy mówią obydwoma językami.

Pełny post na
Wideo
#

Cała nauka to data science

TL;DR Przejście z fizyki do data science było mniej jak zaczynanie od zera, a bardziej jak zmiana instrumentu.

Cała nauka to data science. Jedyna różnica to to, skąd pochodzą dane.

Kiedy przeszłam z fizyki do data science, było to mniej jak zaczynanie od zera, a bardziej jak zmiana instrumentu. Symulacje stały się logami produktu, materiały użytkownikami, a pytania zostały te same: co jest sygnałem, co szumem i jak bardzo jesteśmy pewni?

Spróbuj tego

Naukowcy: wypisz trzy rzeczy, które robisz co tydzień w laboratorium. Teraz przepisz je słowami z data science. To Twoje CV.

Pełny post na
Karuzela
<1%najlepszy wynik AI w zupełnie nowych grach logicznych (ludzie: 100%)
#

6 umiejętności do rozwijania tam, gdzie AI wciąż zawodzi

TL;DR Nowe problemy, prawdziwe doświadczenie, umiejętności miękkie, głęboka ekspertyza, zarządzanie agentami i odporność: tam leży Twoja wartość.

AI szybko się poprawia, ale wciąż zawodzi w przewidywalnych miejscach. I właśnie tam leży Twoja wartość. Inwestuj tam.

  1. Nowe problemy: AI remiksuje to, co znane
  2. Prawdziwe doświadczenie: stanowisk juniorskich w zawodach narażonych na AI ubywa, doświadczonych nie
  3. Umiejętności miękkie: zaufania i przywództwa nie da się zamknąć w prompcie
  4. Głęboka ekspertyza: tuż poza zasięgiem AI osoby korzystające z AI myliły się częściej
  5. Zarządzanie agentami: sprawdzanie ich pracy to nowe wąskie gardło
  6. Odporność: narzędzia zmieniają się co kilka miesięcy
Spróbuj tego

Wybierz jedną umiejętność z listy i w tym miesiącu trenuj ją świadomie.

Pełny post na
Wideo
5rund rozmów na stanowisko data science w Google
#

Jak przygotowałam się do 5 rozmów w Google z pomocą AI

TL;DR Rozpisz tematy, napisz jeden główny dokument, a potem pozwól, żeby AI przepytywało Cię na głos, aż przestanie znajdować luki.

Google dało mi pięć rozmów: trzy ze statystyki i intuicji w danych, jedną z kodowania, jedną z Googleyness. Do wszystkich przygotowałam się z AI i oto dokładnie jak.

Sekretem nie był magiczny kurs. Było nim zamienienie AI w rozmówcę, który nigdy nie męczy się zadawaniem pytań uzupełniających.

  1. Rozpisz tematy: testy A/B, product sense, statystyka, rachunek prawdopodobieństwa, wnioskowanie przyczynowe
  2. Napisz jeden główny dokument ze wszystkimi pojęciami
  3. Daj dokument AI i pozwól, żeby przepytywało Cię na głos
  4. Traktuj rozmówcę jak przyjaznego współpracownika: pytania są otwarte, nie ma idealnej odpowiedzi
Spróbuj tego

Skomentuj pod postem „DATA SCIENCE”, a wyślę Ci mój dokument przygotowawczy.

Pełny post na
Wideo
#

Moja droga z uczelni do Google

TL;DR Chemia, inżynieria materiałowa, fizyka, a potem tech, bo to tam dzieje się teraz zmiana.

Studiowałam chemię, potem inżynierię materiałową, potem fizykę, bo pasjonowała mnie nauka. Gdzieś po drodze zauważyłam, gdzie naprawdę zachodzi zmiana: w tech.

Poszłam więc za nią. Oto krótka wersja tego, jak laboratoryjna dusza trafiła do Google i dlaczego wcale nie uważam tego za odejście od nauki.

Pełny post na
Pracujesz nad czymś w tym obszarze? Współpracujmy →
Współpracujmy

Masz historię, którą dowody powinny opowiedzieć?

Jestem otwarta na współpracę z badaczami, founderami, twórcami narzędzi i innymi twórcami, o ile jest coś prawdziwego do obejrzenia.

01

Wyjaśnij swoje badania

Artykuł lub zbiór danych, który chcesz, żeby zrozumieli ludzie spoza Twojej dziedziny. Zamieniam go w film i historię, które zachowują zastrzeżenia.

02

Rozmowa z gościem

Zmiana ścieżki kariery albo praca, którą ludzie źle rozumieją, jak wywiad z prawniczki, która trafiła do TikToka. Krótko, szczerze, z pożytkiem.

03

Wystąpienia i mentoring

Hackathony, meetupy, koła naukowe: AI w praktyce, kariery w data science, skok z doktoratu do przemysłu.

04

Twórzmy razem z Crocodata

Aplikacja lub narzędzie, które naprawdę chcesz, żeby istniało. Budujemy własne i jesteśmy otwarci na budowanie Twojego.