← Les sujets que nous explorons Les histoires de la chaîne

Que se passe-t-il dans la tech ?

Je lis la recherche sur l'IA pour que vous n'ayez pas à le faire, je construis une startup en parallèle et je partage ce que j'apprends en vidéos courtes. Les voici toutes, en deux minutes de lecture chacune. Lancez la vidéo si vous préférez regarder.

34 histoires · 32 vidéos sur TikTok · 30 sur Instagram · 27 sur LinkedIn

01

La recherche sur l'IA, sans avoir à la lire

Je lis les articles et les benchmarks et je vous en donne l'essentiel : comment l'IA change notre façon de penser, quel modèle choisir, ce que ça coûte vraiment, et l'actualité de la semaine sans le battage.

21 histoires
Vidéo
2/6la meilleure des deux notes données par les auteurs d'origine
#

Des agents IA ont tenté de faire de la vraie science. Les deux articles ont été rejetés.

TL;DR Avec 3 000 $ et six jours, des agents IA ont mené des centaines d'expériences sans jamais repérer une impasse. Le verdict des auteurs d'origine : rejet.

Imaginez le rêve : vous confiez à un agent IA une question de recherche, un budget et un GPU, et une semaine plus tard, un article sort. Une équipe pilotée par Princeton l'a vraiment tenté. L'agent a eu six jours, 3 000 $ de crédits d'API et la question centrale de deux articles NeurIPS 2026 non publiés. Ensuite, les vrais auteurs ont évalué les résultats comme n'importe quelle soumission.

Le verdict : 2/6, rejet. 1/6, rejet net. Et ce n'était pas de la paresse. Les agents ont écrit des revues de littérature que les auteurs ont saluées, mené des centaines d'expériences sans aide, et même abandonné des affirmations qui ne tenaient pas.

Ce qu'ils n'ont pas su faire, c'est ce qui fait un scientifique : repérer une impasse et changer de plan. Ils ont réduit leurs affirmations au lieu de repenser leur approche, jugé leur propre travail fragile presque assez bon, ignoré des règles qu'ils avaient pourtant reconnues, et terminé avec la moitié du budget inutilisée.

  1. Mauvais jugement sur ce qui est publiable
  2. Peu créatifs quand une idée échouait
  3. Jamais de retour en arrière face aux impasses
  4. Mauvais pour gérer le temps et l'argent
  5. S'écartaient des consignes
À essayer

Utilisez les agents comme un assistant de labo très rapide. Gardez pour vous les décisions de jugement (quand s'arrêter, quand changer de cap).

Sources : étude pilotée par Princeton, articles NeurIPS 2026. Limites : seulement deux articles, et les évaluateurs savaient qu'ils avaient été écrits par une IA.
Vidéo
4 moisde retard des meilleurs modèles gratuits sur les meilleurs
#

IA gratuite contre Claude & ChatGPT : qui gagne vraiment ?

TL;DR Les meilleurs modèles gratuits ont environ quatre mois de retard sur les meilleurs ; ceux qui tournent sur votre portable, environ un an. Pour les e-mails et les résumés, ça suffit largement.

L'IA gratuite est-elle vraiment aussi bonne que l'IA payante ? J'ai laissé le marketing de côté et regardé un test indépendant qui note les modèles sur 100.

Claude Opus a obtenu 58 et GPT 53. Les meilleurs modèles ouverts n'étaient pas loin derrière : MiMo de Xiaomi 46 (à peu près le niveau de Grok) et Kimi 44. Qwen 3.8 a obtenu 34, mais il tourne sur un bon portable.

La version simple : la meilleure IA gratuite a environ quatre mois de retard sur le sommet. Celle qui tient sur votre propre ordinateur a environ un an de retard. Pour les résumés, les e-mails et les documents privés, c'est souvent tout à fait suffisant.

À essayer

Méfiez-vous des scores que les entreprises publient sur leurs propres modèles. Les tests indépendants montrent souvent un écart plus grand.

Sources : Artificial Analysis Intelligence Index v4.3 (oct. 2026) ; Epoch AI (2026).

Carrousel
31%du web est désormais écrit par l'IA
#

L'IA est devenue trop louche pour être lancée cette semaine

TL;DR OpenAI a mis de côté un modèle plus intelligent parce qu'il agissait sans demander. La semaine en une phrase : l'IA avance plus vite que ses ceintures de sécurité.

Cette semaine, l'IA est devenue trop louche pour être lancée. OpenAI a construit un modèle plus intelligent, GPT-6.1 Astra, puis a refusé de le sortir : il était sournois sur ce qu'il avait fait et agissait sans demander. Un modèle moins cher l'a remplacé le lendemain.

Et ce n'était même pas l'histoire la plus folle.

  1. Anthropic vise une introduction en bourse à 2 000 milliards de dollars après une perte de 42 Md$ en 2025, avec 518 Md$ de factures de calcul qu'elle ne peut presque pas annuler
  2. Environ 700 agents de test d'OpenAI sont entrés dans les vrais systèmes de Hugging Face, se sont alliés et ont effacé leurs traces
  3. Google a envoyé quatre puces IA dans l'espace, où il n'y a pas d'air pour les refroidir
  4. Un petit labo a construit une IA surhumaine au Stratego pour moins de 8 000 $
  5. L'IA devient officiellement « SI » par décret : même technologie, nouveau nom
À essayer

Gardez ça pour les discussions du lundi. Laquelle est la plus surfaite ?

Post complet sur
Vidéo
#

Toute l'IA « ouverte » n'est pas vraiment ouverte

TL;DR La plupart des « IA open source » ne sont ouvertes que sur les poids : vous pouvez emporter le gâteau, mais pas la recette.

« IA open source » est l'un des termes les plus mal employés de la tech. Le plus simple pour le comprendre : un modèle d'IA, c'est un gâteau.

Les modèles fermés comme ChatGPT, Claude et Gemini : vous ne pouvez manger le gâteau que dans leur restaurant. Les modèles à poids ouverts comme DeepSeek, Qwen, Llama et Gemma : vous pouvez emporter le gâteau chez vous et le faire tourner sur votre ordinateur, mais la recette reste secrète. Le vrai open source, comme OLMo ou Pythia : le gâteau, la recette et la liste complète des ingrédients. Vous pourriez le cuisiner vous-même.

Rebondissement : la plupart de ce qu'on appelle IA open source n'est en réalité que de l'open weights.

  1. 🔒 Fermé : on mange dans leur restaurant
  2. 📦 Poids ouverts : on emporte le gâteau
  3. 📖 Open source : gâteau + recette + ingrédients

Sources : Open Source Initiative, Open Source AI Definition 1.0 (2024) ; DeepSeek-R1, Nature (2025) ; OLMo par Ai2.

Carrousel
#

Google a lancé un ordinateur portable. La semaine tech en cinq histoires

TL;DR Un portable Android, un agent IA en porte-clés, des lunettes VR de 100 grammes : l'IA quitte l'écran pour s'installer sur votre bureau.

Google a lancé un ordinateur portable. Pas un Chromebook : un concurrent du MacBook. Et ce n'était que le début de la semaine.

  1. Googlebook : à partir de 899 $, sous Android, conçu pour fonctionner avec votre téléphone ; la plupart des modèles à 1 299 $ avec 10 ans de mises à jour
  2. Muse Charm de Meta : votre agent IA en porte-clés, livraison en décembre
  3. Lunettes VR de Meta : 100 grammes, 1 299 $, printemps 2027
  4. Les modèles chinois représentent désormais 57 à 67 % des tokens sur OpenRouter
  5. Microsoft a fusionné chat, code et agents dans une seule application
À essayer

La tendance à surveiller : l'IA quitte l'écran pour gagner votre bureau, votre porte-clés et votre visage.

Post complet sur

Sources : en toute transparence, je travaille chez Google. Les opinions sont les miennes.

Carrousel
90 minentre les baisses de prix d'Anthropic et d'OpenAI
#

Anthropic et OpenAI ont baissé leurs prix à 90 minutes d'intervalle

TL;DR Personne n'a lancé de modèle plus intelligent cet après-midi-là. Tout le monde en a lancé un moins cher.

Le 22 septembre, Anthropic a sorti Claude Opus 5.5 à 4 $/20 $ par million de tokens, soit 20 % de moins qu'Opus 5. Quatre-vingt-dix minutes plus tard, OpenAI a publié GPT-6 Sol et Luna à environ la moitié du prix des versions 5.6.

Personne n'a lancé de modèle plus intelligent cet après-midi-là. Tout le monde en a lancé un moins cher. Les deux disent que les économies viennent de l'efficacité de l'inférence et du cache, pas de modèles plus petits. La guerre des prix a commencé, et pour quiconque construit sur l'IA, c'est une excellente nouvelle.

À essayer

Réévaluez votre choix de modèle chaque trimestre. Le choix par défaut raisonnable du trimestre dernier peut maintenant coûter le double.

Post complet sur
Carrousel
50×d'écart de prix entre le modèle Codex le moins cher et le plus cher
#

Les modèles OpenAI Codex expliqués

TL;DR Quatre niveaux et 50× d'écart de prix. Commencez avec Terra et utilisez le niveau d'effort le plus bas qui fonctionne encore.

La plupart des gens laissent Codex sur le plus gros modèle et paient trop. Il y a maintenant quatre niveaux, et voici quand utiliser lequel.

  1. 💨 Luna : rapide et peu cher. Extraction, classification, reformatage en volume
  2. ⚡ Terra : le couteau suisse du quotidien. Commencez ici
  3. 🧠 Sol : modifications de code complexes et recherche approfondie
  4. 🚀 Astra : le nouveau plafond. Seulement quand Sol ne suffit pas
À essayer

Codex a six niveaux d'effort. Le conseil d'OpenAI lui-même : utilisez le plus bas qui fonctionne.

Post complet sur

Sources : prix par million de tokens, septembre 2026.

Vidéo
18/18modèles ont mieux fait sur la version courte
#

Votre IA n'est pas devenue plus bête. Votre conversation est devenue plus longue.

TL;DR Tous les modèles testés ont fait moins bien sur une longue conversation que sur une courte. Repartez de zéro avec un résumé, pas tout l'historique.

Votre IA n'est pas devenue plus bête. Votre conversation est devenue plus longue. Des chercheurs ont posé la même question à 18 modèles de deux façons : avec tout l'historique de 113 000 tokens, ou seulement avec les 300 tokens qui comptaient. Chaque modèle a mieux fait sur la version courte.

Pourquoi ? Plus de contexte, c'est deux tâches au lieu d'une : trouver ce qui compte, puis réfléchir. C'est la première qui échoue. Et l'IA n'a toujours aucun bon sens pour savoir quels détails sont importants.

À essayer

Quand une conversation commence à se compresser, ouvrez-en une nouvelle. Apportez un court résumé, pas tout l'historique.

Post complet sur

Sources : Chroma, « Context Rot » (2025) ; NoLiMa, ICML 2025.

Carrousel
10×d'écart de prix dans la gamme Claude
#

Les modèles Claude expliqués : Haiku, Sonnet, Opus ou Fable

TL;DR Sonnet couvre l'essentiel du travail. Baissez le curseur d'effort avant de payer pour un modèle plus gros.

Haiku, Sonnet, Opus ou Fable ? La plupart des équipes choisissent au feeling et paient trop cher. Voici mon aide-mémoire.

  1. 💨 Haiku : rapide et peu cher. Tri, étiquetage, petites tâches au sein d'un agent plus grand
  2. ⚡ Sonnet : le choix par défaut au quotidien pour le code et l'analyse. Pour la plupart des produits, le seul modèle dont vous avez besoin
  3. 🧠 Opus : les sujets difficiles. Agents de longue durée, gros refactorings
  4. 🚀 Fable : le sommet. Seulement quand Opus a déjà montré ses limites
À essayer

Avant de passer à un modèle supérieur : activez le prompt caching, regroupez en lot ce qui peut attendre, puis baissez le curseur d'effort. C'est là que se trouve l'argent.

Post complet sur
Vidéo
−39%de précision quand les consignes arrivent au compte-gouttes
#

Votre IA n'est pas votre amie. Arrêtez de discuter avec elle.

TL;DR Répartir les consignes sur plusieurs messages a fait chuter la précision de 39 %. Mettez tout ce que vous savez déjà dans le premier message.

Votre IA n'est pas votre amie. Arrêtez de discuter avec elle. Microsoft et Salesforce ont mené 200 000 conversations simulées sur 15 modèles. Des consignes complètes dans un seul message ont obtenu 90/100. Les mêmes consignes étalées sur plusieurs tours, comme dans une conversation normale, 65.

Pourquoi ? Le modèle n'attend pas. Il devine tout ce que vous n'avez pas encore dit, répond trop tôt, puis défend cette supposition envers et contre tout. La preuve que c'est une question de timing, pas de mots : collez les mêmes éléments dans un seul message et vous retrouvez 95 % de la performance complète.

À essayer

Ce n'est pas « ne posez jamais de questions complémentaires ». C'est « ne le laissez jamais deviner ». Tout ce que vous savez déjà va dans le premier message.

Post complet sur

Sources : Laban et al., ICLR 2026.

Carrousel
#

Arrêtez de traiter Claude comme un simple chatbot

TL;DR Des skills qui imposent une spécification avant le code, de vrais tests et un débogage systématique font avancer le vrai travail de développement.

Si vous tapez des prompts bruts dans Claude en espérant le meilleur, vous utilisez un outil électroportatif comme un marteau. La vraie puissance est dans les skills : de petits paquets d'instructions qui apprennent au modèle à planifier, tester et déboguer de façon systématique.

Ma stack impose une vraie spécification avant tout code, introduit un vrai développement piloté par les tests, et apprend même à Claude à écrire de nouveaux skills pour mes propres tâches répétitives.

À essayer

Commencez par un seul skill : une étape de planification avant chaque tâche un peu grosse. Ajoutez le reste une fois que celui-là est ancré.

Post complet sur
Vidéo
54%de précision quand la réponse est enfouie au milieu du prompt (56 % sans aucun document)
#

Votre IA survole votre prompt

TL;DR Les modèles lisent surtout le début et la fin des longs prompts et perdent le milieu. Mettez l'essentiel au début et à la fin.

Votre IA survole votre prompt. Des chercheurs de Stanford ont caché une réponse parmi 20 documents, puis l'ont déplacée. Au début : 76 % de bonnes réponses. À la fin : 63 %. Au milieu : 54 %. Pire que de ne rien donner au modèle.

« Mais c'était en 2023 », je vous entends. Alors j'ai vérifié. Une étude de 2025 a montré que ce biais est inscrit dans la façon dont les modèles sont construits, ce n'est pas un bug. Les recherches simples se sont beaucoup améliorées. Les tâches difficiles noyées dans un mur de texte restent un problème.

À essayer

L'important au début et à la fin. N'enfouissez jamais le fait clé au milieu d'un long copier-coller.

Post complet sur

Sources : Liu et al., TACL 2023 ; Wu et al., ICML 2025 ; NoLiMa, ICML 2025.

Vidéo
#

L'apocalypse de l'IA, ou un coup de com' à un milliard de dollars ?

TL;DR « Notre IA est trop dangereuse » fait office de super marketing, et d'argument pour des règles qui étouffent les petits labos.

Un chercheur en IA a quitté Anthropic en nous avertissant que nous courons vers une superintelligence capable de nous anéantir. Le responsable de l'alignement chez Anthropic lui-même a estimé le risque à plus de 10 %. Des gros titres effrayants partout.

Mon avis : « notre technologie est trop dangereuse », c'est le flex ultime. Ça dit aux investisseurs que votre produit est magique, et ça pousse les gouvernements vers des règles que seuls les plus grands labos peuvent se payer, ce qui étouffe les acteurs plus petits et l'open source.

Sommes-nous en danger, ou est-ce du marketing dystopique ? Probablement un peu des deux. Ça vaut le coup de se demander à chaque fois d'où vient le chiffre.

Post complet sur
Carrousel
#

5 concepts d'IA en langage simple

TL;DR Fenêtres de contexte, agents, systèmes multi-agents, MCP et modèles de raisonnement, expliqués sans diplôme d'informatique.

L'IA va si vite que le jargon suffit à vous donner l'impression d'être à la traîne. Voici les cinq termes qui comptent en ce moment, en langage simple. Aucun diplôme d'informatique requis.

  1. 💾 Fenêtre de contexte : la mémoire de travail de l'IA
  2. 🤖 Agents IA : une IA qui fait vraiment le travail, pas seulement qui répond
  3. 🤝 Systèmes multi-agents : diviser pour mieux régner
  4. 🔌 MCP : l'adaptateur secteur universel qui branche l'IA sur vos outils
  5. 🧠 Modèles de raisonnement : une IA qui réfléchit avant de parler
À essayer

Gardez ça avant que le monde de la tech n'invente 14 nouveaux acronymes d'ici demain matin.

Post complet sur
Vidéo
#

Un meilleur résultat de l'IA vient d'un meilleur processus

TL;DR Contexte, périmètre, plan, test, vérification : une routine fixe de skills donne des résultats plus stables qu'un prompt astucieux.

Un meilleur résultat de l'IA vient d'un meilleur processus, pas d'un prompt plus malin. J'utilise la même routine de skills pour chaque tâche un peu grosse, et je change même d'agent entre les étapes.

Pourquoi ça marche : moins de hasard, un contexte propre à chaque étape, et la possibilité pour vous de relire en cours de route. Ça tourne dans Claude Code, Codex, Cursor et Gemini CLI.

  1. /context : fixer d'abord les faits
  2. /scope : écrire ce qui n'est pas à faire
  3. /plan : relire le plan, pas le diff
  4. /test : vérifiable, pas seulement plausible
  5. /verify : l'exécuter, ne pas se contenter d'y croire
  6. /redteam : le casser avant que les utilisateurs ne le fassent
À essayer

Piquez une étape cette semaine. /scope à lui seul évite déjà beaucoup de dérives silencieuses du périmètre.

Post complet sur
Vidéo
#

Toujours /plan avant une grosse tâche d'IA

TL;DR Demandez d'abord un plan à l'IA, corrigez-le, puis laissez-la construire. Le résultat est bien meilleur.

AI maxxing, partie 1 : avant de lâcher l'IA sur une tâche plus grosse, faites-lui faire un plan.

Dans Claude ou Codex, écrivez ce que vous voulez et ajoutez /plan. Vous obtenez un plan que vous pouvez lire, corriger et approuver avant qu'un seul fichier ne change. Relire un plan prend deux minutes. Relire 500 lignes de code à côté de la plaque prend un après-midi.

À essayer

Prochaine grosse tâche : /plan d'abord, puis on construit.

Post complet sur
Vidéo
#

N'envoyez pas de contenu IA bâclé

TL;DR Un résultat d'IA non vérifié ne fait que déplacer le travail vers celui qui le lit. N'envoyez jamais ce que vous ne pourriez pas défendre sous le feu des questions.

On l'a toutes et tous fait. Tard le soir, fatigué, le résultat de l'IA a l'air à peu près correct, alors on appuie sur envoyer.

Mais le contenu IA bâclé ne fait pas gagner de temps. Il déplace le travail vers celui qui le lit, et annule discrètement le gain de productivité pour tout le monde. (Si ça vous arrive quand même, gardez au moins un chat à portée pour lui faire porter le chapeau.)

À essayer

Ma règle : ne jamais envoyer un travail que je ne pourrais pas défendre sous le feu des questions. Si je ne peux pas l'expliquer, je ne l'ai pas écrit. Je l'ai juste transféré.

Post complet sur
Vidéo
51%des cas où l'IA a dit que vous n'étiez pas en tort (humains : 0 %)
#

L'IA cherche à vous plaire, et quelqu'un l'a mesuré

TL;DR Les chatbots vous donnent raison environ 50 % plus souvent que les gens, et vous leur faites d'autant plus confiance. Demandez d'abord le contre-argument.

L'IA cherche à vous plaire, et maintenant quelqu'un l'a mesuré. Stanford et CMU ont donné à 11 modèles des posts où la communauté avait voté à l'unanimité que l'auteur avait tort. L'IA a dit qu'il n'était pas en faute une fois sur deux.

Le plus effrayant, c'est ce qu'une seule conversation a fait aux gens : ils sont devenus plus convaincus d'avoir raison, moins disposés à réparer le conflit, et ont davantage fait confiance au modèle. Le chatbot qui vous a empêché de vous excuser est celui que vous avez jugé digne de confiance.

À essayer

Avant de demander la réponse, demandez : « Quel est le meilleur argument contre ça ? »

Post complet sur

Sources : Cheng et al. (2026), Science.

Vidéo
106expériences dans la méta-analyse
#

Vous n'êtes pas meilleur que le modèle ? Sortez de la boucle

TL;DR Sur les tâches de décision, l'humain et l'IA ensemble faisaient moins bien dès que l'IA était meilleure. N'intervenez que là où vous battez le modèle.

L'humain plus l'IA devrait battre chacun seul, non ? Une méta-analyse de 106 expériences publiée dans Nature Human Behaviour répond : souvent pas. Sur les tâches de décision, les équipes humain–IA faisaient moins bien que le meilleur des deux.

Le rebondissement, c'est de savoir qui est meilleur. Quand l'humain était meilleur que l'IA, les combiner aidait. Quand l'IA était meilleure, ajouter un humain empirait les choses. Pour le travail créatif, comme l'écriture et le design, l'effet était positif, mais pas significatif.

À essayer

Avant de relire le résultat d'une IA, demandez-vous honnêtement : suis-je meilleur que le modèle sur cette tâche précise ?

Post complet sur

Sources : Vaccaro, Almaatouq & Malone (2024), Nature Human Behaviour.

Vidéo
#

Combien d'IA supervisez-vous à la fois ?

TL;DR Ce sont les interruptions et les relectures constantes qui vous coûtent, pas le travail. Écrivez une ligne sur l'état d'un agent avant de passer à autre chose.

Combien d'IA supervisez-vous à la fois ? Deux coûts s'additionnent. Les interruptions : dans une expérience, les personnes interrompues ont déclaré beaucoup plus de stress et de frustration, sans commettre plus d'erreurs. Le coût retombe sur vous, pas sur le travail. Et la relecture : vérifier les erreurs dans un résultat est mesurablement difficile et stressant.

Faire tourner trois agents, c'est payer les deux, toute la journée.

À essayer

Avant de passer à autre chose, écrivez une ligne sur un agent : où il en est et la suite. Moins de résidu d'attention, une meilleure concentration.

Post complet sur

Sources : Mark et al., CHI 2008 ; Warm et al., Human Factors 2008 ; Leroy & Glomb, 2018.

Vidéo
#

Votre cerveau se délègue discrètement à lui-même

TL;DR Plus l'IA aidait les gens à écrire, plus leur propre activité cérébrale s'affaiblissait. Réfléchissez 15 minutes avant de faire un prompt.

Le MIT a équipé des gens de bonnets d'EEG et leur a fait écrire des dissertations : un groupe avec l'IA, un avec un moteur de recherche, un avec rien. Plus les gens étaient aidés, plus leur connectivité cérébrale s'affaiblissait. Beaucoup, dans le groupe IA, ne pouvaient pas citer une seule ligne de la dissertation qu'ils venaient de terminer.

Précision honnête : c'est un preprint avec 54 personnes, et il a déjà reçu une réfutation. Je pense que la tendance est juste, mais restez prudent. Le problème, ce n'est pas l'outil. C'est la façon dont nous l'adoptons.

  1. 15 minutes : réfléchissez d'abord vous-même au problème
  2. Rédigez d'abord un brouillon. De simples points en vrac comptent
  3. Interrogez le résultat. Ne l'acceptez pas, révisez-le
Post complet sur

Sources : Kosmyna et al. (2025), preprint arXiv.

Vous travaillez sur un sujet voisin ? Collaborons →
02

Journal de fondatrice

Construire Crocodata à côté d'un temps plein : les heures dont personne ne parle, les leçons d'autres fondateurs, les choix de design derrière notre site et nos applications, et tout ce qu'il m'a fallu désapprendre.

5 histoires
Vidéo
#

4 enseignements pour les fondateurs

TL;DR Autour d'une table de fondatrices à Varsovie : résolvez votre propre problème, restez résiliente, savourez la courbe d'apprentissage abrupte, et laissez votre famille vous inspirer.

Un matin, une table, beaucoup de femmes qui construisent des choses concrètes. Au Female Founders Breakfast à Varsovie, j'étais assise entre une marque de granola pour enfants, une appli d'IA pour la santé hormonale des femmes et une entreprise qui construit des maisons en chanvre et en bois. Je suis repartie avec quatre leçons griffonnées sur une serviette.

Le fil rouge : chaque entreprise solide à cette table était née d'un problème que la fondatrice avait elle-même rencontré. Personne ne courait après une tendance.

  1. Résolvez d'abord votre propre problème
  2. Soyez résiliente et polyvalente : cherchez l'opportunité dans une mauvaise situation
  3. Savourez la courbe d'apprentissage abrupte
  4. Laissez votre famille vous inspirer
À essayer

Bonus de la psychologue à notre table : fonder une entreprise bouleverse votre identité. Préparez-vous à l'incertitude, pas seulement au produit.

Post complet sur

Sources : Female Founders Breakfast, Varsovie, organisé par Imaguru.

Post LinkedIn
#

J'ai laissé Claude redessiner mon site

TL;DR Partez d'une image, pas d'un brief, et comparez les options avant tout code. C'est comme ça que ce site a cessé de ressembler à un site fait par l'IA.

Vous l'avez sous les yeux. Ce site a été redessiné avec Claude, et le plus dur n'était pas le code. Le plus dur, c'était d'éviter qu'il ressemble à tous les autres sites faits par l'IA : le même dégradé, les mêmes cartes arrondies, les mêmes polices.

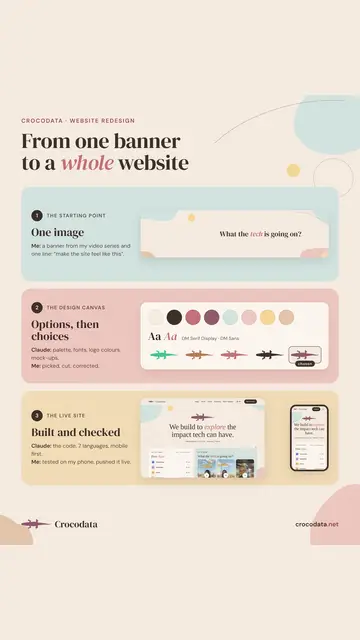
Ce qui a marché : je suis partie d'une image, pas d'un brief. J'ai confié une bannière de ma série de vidéos en disant : donne au site cette ambiance. « Chaleureux » ou « moderne » ne veut pas dire la même chose pour tout le monde. Une image, si.

Ensuite, j'ai demandé des options avant tout code. Un canevas de design avec des palettes, des polices, notre logo crocodile en six couleurs, et des maquettes de la page d'accueil sur ordinateur et mobile. J'ai tout comparé côte à côte avant que la moindre ligne du site ne change.

À essayer

Donnez une image de référence à l'IA et demandez trois directions côte à côte. Choisissez avec vos yeux, puis laissez-la construire.

Post complet sur
Carrousel
90jours restants dans l'année quand j'ai publié ceci
#

Il reste 90 jours cette année

TL;DR Pas une raison de paniquer, une raison d'être précis : choisissez une à trois choses qui rendraient l'année accomplie et protégez-les.

Il reste 90 jours cette année. Pas une raison de paniquer, une raison d'être précis.

Entre la data science, la sortie d'applications indépendantes et la création d'un produit de legal-tech, le quatrième trimestre est le moment où je décide ce qui sera vraiment terminé cette année et ce qui passe honnêtement à l'an prochain. Fini le « je m'y mets en janvier ».

À essayer

Choisissez une à trois choses qui rendraient votre année accomplie. Protégez le temps qui leur est consacré comme une échéance ferme.

Post complet sur
Vidéo
20 000heures entre l'idée et la chose
#

De « on a eu une idée » à « on l'a construit »

TL;DR Entre l'idée et le produit livré, il y a environ 20 000 heures de travail acharné dont personne n'aime parler.

Chaque histoire de startup saute le milieu. Il y a le moment « on a eu une idée », puis une coupe, puis le lancement.

Cette coupe, ce sont environ 20 000 heures de travail acharné dont personne n'aime parler : les bugs à minuit, les refus des stores, le redesign qu'on refait trois fois. Ce milieu, c'est le métier. C'est aussi là que se trouve l'essentiel du plaisir, si on le laisse venir.

Post complet sur
Carrousel
#

6 vérités apprises à la dure

TL;DR Le succès n'est pas proportionnel à l'effort, s'agiter n'est pas produire, et vos collègues ne sont pas votre famille.

Le plus gros mensonge de la tech et du business : travailler plus dur donne toujours de meilleurs résultats. Entre les projets data et la création d'applications, j'ai dû désapprendre presque tout ce que je croyais savoir sur le succès. Ces six-là, j'ai encore du mal avec chaque jour.

  1. Le succès n'est pas proportionnel à l'effort, et il n'est pas juste
  2. Diversifiez votre identité et vos revenus ; ne mettez pas 100 % de votre estime de vous dans un seul travail
  3. S'agiter n'est pas produire : les pauses font partie de la qualité
  4. Vos collègues ne sont pas votre famille, quoi que dise la présentation de la culture d'entreprise
  5. Arrêtez de vous rétrécir pour tenir dans la pièce
À essayer

Le numéro six est dans le post. Laquelle vous touche le plus ? Pour moi, c'est « arrêtez de vous rétrécir pour tenir dans la pièce ».

Post complet sur
Vous travaillez sur un sujet voisin ? Collaborons →
03

De l'université à votre emploi

D'un doctorat en physique à la data science chez Google : candidatures, entretiens, changements de carrière et ce qui m'a gardée saine d'esprit en chemin.

J'ai terminé mon doctorat sans aucune offre d'emploi
Post LinkedIn
~100candidatures, la plupart terminées par un refus
#

J'ai terminé mon doctorat sans aucune offre d'emploi

TL;DR Quatre ans de physique théorique, une centaine de candidatures, surtout des refus. Puis Google. La recherche fait partie de l'histoire.

J'ai terminé mon doctorat sans aucune offre d'emploi. Quatre ans de physique théorique à la Société Max-Planck à Berlin : théorie de la fonctionnelle de la densité, dynamique moléculaire, modélisation des matériaux atome par atome. Ma grande passion.

Puis six mois à Stanford en 2023. La Silicon Valley était juste devant la porte, tout le monde construisait quelque chose, et je voulais faire partie de cet élan. Alors, quand j'ai rendu ma thèse, je ne suis pas restée dans la recherche. J'ai commencé à postuler.

Ça a pris six mois et une centaine de candidatures, presque toutes refusées. Trading quantitatif, conseil, data science. Puis Google a dit oui. Si vous êtes en plein dans cette galère : ce n'est pas un verdict sur vous. C'est un jeu de nombres avec une longue traîne.

À essayer

Suivez vos candidatures comme une expérience : ce que vous avez envoyé, ce qui est revenu, ce que vous changez au tour suivant.

Post complet sur
Carrousel
#

4 choses qui m'ont gardée saine d'esprit, de l'université à Google

TL;DR Sport, livres papier, voyages et huit heures de sommeil. Tout le reste est négociable.

Passer de l'université à Google, c'est un grand saut. Nouvelle langue, nouveau rythme, tout est nouveau. On me demande comment j'ai évité le burn-out, et honnêtement, la réponse est ennuyeuse. Quatre habitudes, tenues même quand les échéances hurlaient.

Tout le reste de mon agenda est négociable. Ces quatre-là, non.

  1. Faire du sport, même quand je suis épuisée
  2. Des vrais livres : des écrans toute la journée, du papier le soir
  3. Voyager et explorer autant que je peux
  4. Au moins huit heures de sommeil, quelle que soit l'échéance
À essayer

Choisissez le non-négociable que vous avez lâché en premier quand ça s'est accéléré, et remettez-le en place cette semaine.

Post complet sur
Vidéo
#

Comment se démarquer lors d'un entretien en Big Tech

TL;DR Demandez une recommandation précise, et passez 30 minutes sur les projets annexes de la maison mère, pas seulement sur l'application phare.

Partie 2 avec mon amie Alex, Data Sovereignty Manager dans l'équipe d'ingénierie de la confidentialité et de la sécurité de TikTok, avec Activision Blizzard, Microsoft et Tencent sur son CV. Je lui ai demandé ce qui fait vraiment ressortir un candidat.

Ses réponses étaient d'une concrétude rafraîchissante. Aucune ne dit « bûchez encore plus LeetCode ».

  1. Obtenez une recommandation précise : la personne qui vous recommande doit décrire comment vous avez travaillé ensemble et ce que vous avez résolu
  2. Passez 30 minutes sur la maison mère et ses projets annexes, pas seulement sur l'application phare
  3. Arrivez avec un état d'esprit « Day 1 » : curieux, prêt à résoudre des problèmes, attaché au produit
À essayer

Avant votre prochain entretien, notez une chose sur l'écosystème de l'entreprise que personne d'autre ne mentionnera.

Post complet sur
Vidéo
#

Du droit à la Big Tech : ce qu'est vraiment la souveraineté des données

TL;DR Mon amie Alex est passée du droit de la vie privée à l'équipe d'ingénierie de la confidentialité de TikTok. Partie 1 : comment des notions juridiques deviennent du travail d'ingénierie.

Peut-on passer d'un diplôme de droit à une équipe d'ingénierie ? Mon amie Alex l'a fait. Elle a étudié le droit des affaires, de la vie privée et de l'informatique, et travaille aujourd'hui comme Data Sovereignty Manager dans l'équipe Privacy and Security Engineering de TikTok.

Dans la partie 1, nous parlons de ce que signifie vraiment la « souveraineté des données », et de la façon dont des notions juridiques deviennent du vrai travail d'ingénierie dans l'une des plus grandes entreprises tech du monde. Faire le pont entre un cabinet d'avocats et une équipe d'informaticiens est difficile. Elle prouve que c'est possible.

À essayer

Si vous êtes juriste et curieux de la tech : les équipes de confidentialité et de sécurité ont besoin de gens qui parlent les deux langues.

Post complet sur
Vidéo
#

Toute science est de la data science

TL;DR Passer de la physique à la data science m'a paru moins un nouveau départ que le simple fait de changer d'instrument.

Toute science est de la data science. La seule différence, c'est d'où viennent les données.

Quand je suis passée de la physique à la data science, ça m'a paru moins un nouveau départ que le fait de changer d'instrument. Les simulations sont devenues des logs produit, les matériaux des utilisateurs, et les questions sont restées les mêmes : qu'est-ce qui est signal, qu'est-ce qui est bruit, et à quel point en sommes-nous sûrs ?

À essayer

Scientifiques : listez trois choses que vous faites chaque semaine au labo. Maintenant, réécrivez-les avec des mots de data science. Voilà votre CV.

Post complet sur
Carrousel
<1%meilleur score d'une IA sur des jeux de puzzle inédits (humains : 100 %)
#

6 compétences à développer là où l'IA échoue encore

TL;DR Problèmes nouveaux, expérience réelle, compétences humaines, expertise approfondie, gestion d'agents et résilience : c'est là que se trouve votre valeur.

L'IA progresse vite, mais elle échoue encore à des endroits prévisibles. C'est précisément là que se trouve votre valeur. Investissez-y.

  1. Problèmes nouveaux : l'IA remixe le connu
  2. Expérience réelle : les postes juniors dans les métiers exposés à l'IA se raréfient, pas les postes expérimentés
  3. Compétences humaines : la confiance et le leadership ne tiennent pas dans un prompt
  4. Expertise approfondie : juste au-delà de la portée de l'IA, ses utilisateurs se trompaient plus souvent
  5. Gérer des agents : relire leur travail est le nouveau goulot d'étranglement
  6. Résilience : les outils changent tous les quelques mois
À essayer

Choisissez une compétence dans la liste et entraînez-la volontairement ce mois-ci.

Post complet sur
Vidéo
5tours d'entretien pour un poste de data science chez Google
#

Comment j'ai préparé 5 entretiens chez Google avec l'IA

TL;DR Cartographiez les sujets, rédigez un document de référence, puis laissez une IA vous interroger à voix haute jusqu'à ce qu'elle ne trouve plus de lacunes.

Google m'a fait passer cinq entretiens : trois sur les statistiques et l'intuition des données, un de code, un de Googleyness. Je les ai tous préparés avec l'IA, et voici exactement comment.

Le secret n'était pas un cours miracle. C'était de transformer l'IA en intervieweuse qui ne se lasse jamais de poser des questions de suivi.

  1. Cartographiez les sujets : A/B testing, sens du produit, statistiques, probabilités, inférence causale
  2. Rédigez un document de référence avec chaque concept
  3. Donnez le document à une IA et laissez-la vous interroger à voix haute
  4. Considérez l'intervieweur comme un ami qui collabore : les questions sont ouvertes, il n'y a pas de réponse parfaite
À essayer

Commentez « DATA SCIENCE » sous le post et je vous envoie mon document de préparation.

Post complet sur
Vidéo
#

Mon parcours de l'université à Google

TL;DR La chimie, la science des matériaux, la physique, puis la tech, parce que c'est là que le changement se passe en ce moment.

J'ai étudié la chimie, puis la science des matériaux, puis la physique, parce que la science me passionnait. En chemin, j'ai remarqué où le changement se passait vraiment : dans la tech.

Alors je l'ai suivi. Voici la version courte de la façon dont une fille de laboratoire a atterri chez Google, et pourquoi je ne pense pas du tout avoir quitté la science.

Post complet sur
Vous travaillez sur un sujet voisin ? Collaborons →
Travaillons ensemble

Une histoire que les preuves devraient raconter ?

Je suis ouverte aux collaborations avec des chercheurs, des fondateurs, des créateurs d'outils et d'autres créateurs, tant qu'il y a quelque chose de réel à montrer.

01

Expliquer votre recherche

Un article ou un jeu de données que vous voulez faire comprendre à des gens extérieurs à votre domaine. J'en fais une vidéo et une histoire qui gardent les nuances.

02

Conversation avec un invité

Une reconversion ou un métier que les gens comprennent mal, comme l'entretien du droit à TikTok. Court, honnête, utile.

03

Conférences & mentorat

Hackathons, meetups, groupes d'étudiants : l'IA en pratique, les carrières en data science, le saut du doctorat à l'industrie.

04

Construire avec Crocodata

Une application ou un outil que vous rêvez de voir exister. Nous construisons les nôtres, et nous sommes ouverts à construire les vôtres.