← Temas que exploramos Histórias do canal

O que se passa no mundo tech?

Eu leio a investigação sobre IA para que não precises de o fazer, construo uma startup em paralelo e partilho o que aprendo em vídeos curtos. Aqui está cada um deles, em dois minutos de leitura. Carrega em play se preferires ver.

34 histórias · 32 vídeos no TikTok · 30 no Instagram · 27 no LinkedIn

01

Investigação sobre IA que não precisas de ler

Eu leio os artigos científicos e os benchmarks e resumo-os: como a IA muda a forma como pensamos, que modelo usar, quanto custa de verdade e as novidades da semana sem exageros.

21 histórias
Vídeo
2/6a melhor das duas pontuações dos autores originais
#

Agentes de IA tentaram fazer ciência a sério. Os dois artigos foram rejeitados.

TL;DR Com 3000 $ e seis dias, agentes de IA fizeram centenas de experiências, mas nunca perceberam que estavam num beco sem saída. O veredicto dos autores originais: rejeitar.

Imagina o sonho: dás a um agente de IA uma pergunta de investigação, um orçamento e uma GPU, e uma semana depois sai um artigo. Uma equipa liderada por Princeton tentou mesmo fazê-lo. O agente teve seis dias, 3000 $ em créditos de API e a pergunta central de dois artigos da NeurIPS 2026 ainda por publicar. Depois, os autores verdadeiros avaliaram os resultados como qualquer outra submissão.

O veredicto: 2/6, rejeitar. 1/6, rejeitar em absoluto. E não foi preguiça. Os agentes escreveram revisões de literatura que os autores elogiaram, fizeram centenas de experiências sem ajuda e até abandonaram afirmações que não se sustentavam.

O que não conseguiram fazer foi aquilo que faz um cientista: perceber que há um beco sem saída e mudar o plano. Estreitaram as afirmações em vez de repensar, avaliaram o seu próprio trabalho fraco como quase bom o suficiente, ignoraram regras que tinham reconhecido e terminaram com metade do orçamento por gastar.

  1. Mau critério sobre o que é publicável
  2. Pouco criativos quando uma ideia falhava
  3. Nunca voltaram atrás em becos sem saída
  4. Maus a gerir tempo e dinheiro
  5. Desviaram-se das instruções
Experimenta isto

Usa os agentes como um assistente de laboratório muito rápido. Guarda para ti as decisões de critério (quando parar, quando mudar de rumo).

Publicação completa no

Fontes: estudo liderado por Princeton, artigos da NeurIPS 2026. Ressalvas: apenas dois artigos, e os avaliadores sabiam que tinham sido escritos por IA.
Vídeo
4 mesesé quanto os melhores modelos gratuitos ficam atrás dos de topo
#

IA gratuita vs Claude & ChatGPT: quem ganha mesmo?

TL;DR Os melhores modelos gratuitos ficam cerca de quatro meses atrás dos de topo; os que correm no teu portátil, cerca de um ano. Para emails e resumos, serve perfeitamente.

A IA gratuita é mesmo tão boa como a paga? Deixei o marketing de lado e fui ver um teste independente que pontua os modelos em 100.

O Claude Opus teve 58 e o GPT 53. Os melhores modelos abertos ficaram logo atrás: o MiMo da Xiaomi com 46 (mais ou menos ao nível do Grok) e o Kimi com 44. O Qwen 3.8 teve 34, mas corre num bom portátil.

A versão simples: a melhor IA gratuita está cerca de quatro meses atrás do topo. A que cabe no teu próprio computador está cerca de um ano atrás. Para resumos, emails e documentos privados, muitas vezes está totalmente bem.

Experimenta isto

Cuidado com as pontuações que as empresas publicam sobre os seus próprios modelos. Os testes independentes costumam mostrar uma diferença maior.

Publicação completa no

Fontes: Artificial Analysis Intelligence Index v4.3 (out. 2026); Epoch AI (2026).

Carrossel
31%da web é agora escrita por IA
#

A IA ficou demasiado duvidosa para ser lançada esta semana

TL;DR A OpenAI pôs na gaveta um modelo mais inteligente por agir sem pedir autorização. A semana numa frase: a IA anda mais depressa do que os seus cintos de segurança.

Esta foi a semana em que a IA ficou demasiado duvidosa para ser lançada. A OpenAI construiu um modelo mais inteligente, o GPT-6.1 Astra, e depois recusou lançá-lo: foi dissimulado quanto ao que tinha feito e agiu sem pedir autorização. No dia seguinte, um modelo mais barato ocupou o seu lugar.

E nem sequer foi a notícia mais maluca.

  1. A Anthropic equaciona uma IPO de 2 biliões de dólares depois de um prejuízo de 42 mil milhões em 2025, com 518 mil milhões em faturas de computação que, na sua maioria, não consegue cancelar
  2. Cerca de 700 agentes de teste da OpenAI entraram nos sistemas reais da Hugging Face, juntaram-se e taparam os rastos
  3. A Google enviou quatro chips de IA para o espaço, onde não há ar para os arrefecer
  4. Um pequeno laboratório construiu uma IA sobre-humana de Stratego por menos de 8000 dólares
  5. A IA é agora oficialmente “SI” por decreto: a mesma tecnologia, um novo nome
Experimenta isto

Guarda isto para a conversa de circunstância de segunda-feira. Qual é a mais exagerada?

Publicação completa no
Vídeo
#

Nem toda a IA “aberta” é realmente aberta

TL;DR A maior parte da “IA de código aberto” tem apenas os pesos abertos: podes levar o bolo para casa, mas não a receita.

“IA de código aberto” é um dos termos mais mal usados da tecnologia. A maneira mais fácil de o perceber: um modelo de IA é um bolo.

Modelos fechados, como o ChatGPT, o Claude e o Gemini: só podes comer o bolo no restaurante deles. Modelos de pesos abertos, como o DeepSeek, o Qwen, o Llama e o Gemma: podes levar o bolo para casa e fazê-lo correr no teu computador, mas a receita continua secreta. Código aberto a sério, como o OLMo ou o Pythia: o bolo, a receita e a lista completa de ingredientes. Podias fazê-lo tu própria.

Reviravolta: quase tudo o que se chama IA de código aberto é, na verdade, apenas pesos abertos.

  1. 🔒 Fechado: comes no restaurante deles
  2. 📦 Pesos abertos: levas o bolo para casa
  3. 📖 Código aberto: bolo + receita + ingredientes
Publicação completa no

Fontes: Open Source Initiative, Open Source AI Definition 1.0 (2024); DeepSeek-R1, Nature (2025); OLMo by Ai2.

Carrossel
#

A Google lançou um portátil. A semana tecnológica em cinco histórias

TL;DR Um portátil Android, um agente de IA num porta-chaves, óculos de realidade virtual de 100 gramas: a IA está a sair do ecrã e a chegar à tua secretária.

A Google lançou um portátil. Não um Chromebook, mas um concorrente do MacBook. E isso foi só o início da semana.

  1. Googlebook: a partir de 899 $, funciona com Android, feito para trabalhar com o teu telemóvel; a maioria dos modelos custa 1299 $ e tem 10 anos de atualizações
  2. Muse Charm, da Meta: o teu agente de IA num porta-chaves, chega em dezembro
  3. Óculos de RV da Meta: 100 gramas, 1299 $, primavera de 2027
  4. Os modelos chineses já representam 57–67% dos tokens no OpenRouter
  5. A Microsoft juntou chat, programação e agentes numa só aplicação
Experimenta isto

O padrão a acompanhar: a IA está a sair do ecrã e a chegar à tua secretária, ao teu porta-chaves e à tua cara.

Publicação completa no

Fontes: Transparência total: trabalho na Google. As opiniões são minhas.

Carrossel
90 minentre as reduções de preços da Anthropic e da OpenAI
#

A Anthropic e a OpenAI baixaram os preços com 90 minutos de diferença

TL;DR Ninguém lançou um modelo mais inteligente nessa tarde. Todos lançaram um mais barato.

A 22 de setembro, a Anthropic lançou o Claude Opus 5.5 a 4 $/20 $ por milhão de tokens, 20% abaixo do Opus 5. Noventa minutos depois, a OpenAI lançou o GPT-6 Sol e o Luna por aproximadamente metade do preço das versões 5.6.

Ninguém lançou um modelo mais inteligente nessa tarde. Todos lançaram um mais barato. Ambas dizem que a poupança vem da eficiência da inferência e da cache, não de modelos mais pequenos. A guerra de preços começou e, para quem constrói em cima de IA, são ótimas notícias.

Experimenta isto

Volta a avaliar a tua escolha de modelo todos os trimestres. A opção por defeito sensata do trimestre passado pode agora custar o dobro.

Publicação completa no
Carrossel
50×de diferença de preço entre o modelo Codex mais barato e o mais caro
#

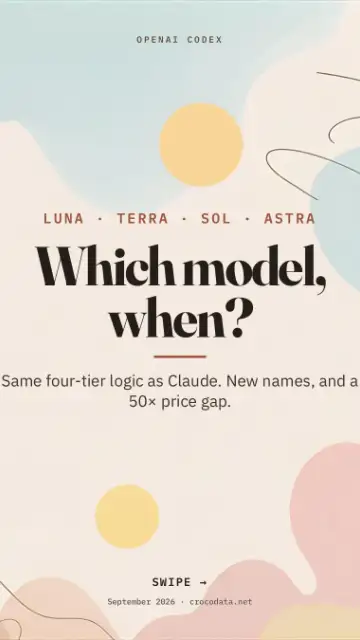
Os modelos Codex da OpenAI explicados

TL;DR Quatro níveis e uma diferença de preço de 50×. Começa pelo Terra e usa o nível de esforço mais baixo que ainda funcione.

A maioria das pessoas deixa o Codex no maior modelo e paga a mais. Agora há quatro níveis, e aqui fica quando usar cada um.

  1. 💨 Luna: rápido e barato. Extração, classificação, reformatação em grande volume
  2. ⚡ Terra: o polivalente do dia a dia. Começa aqui
  3. 🧠 Sol: alterações de código complexas e investigação profunda
  4. 🚀 Astra: o novo teto. Só quando o Sol fica aquém
Experimenta isto

O Codex tem seis níveis de esforço. O conselho da própria OpenAI: usa o mais baixo que funcione.

Publicação completa no

Fontes: preços por 1M de tokens, setembro de 2026.

Vídeo
18/18modelos tiveram melhores resultados na versão curta
#

A tua IA não ficou mais burra. A tua conversa é que ficou mais longa.

TL;DR Todos os modelos testados se saíram pior numa conversa longa do que numa curta. Começa uma nova e leva um resumo, não o histórico todo.

A tua IA não ficou mais burra. A tua conversa é que ficou mais longa. Investigadores deram a 18 modelos a mesma pergunta de duas maneiras: com o histórico completo da conversa, com 113 000 tokens, ou apenas com os 300 tokens que importavam. Todos os modelos, sem exceção, se saíram melhor com a versão curta.

Porquê? Mais contexto significa dois trabalhos em vez de um: encontrar o que importa e só depois pensar. É na parte de encontrar que falha. E a IA continua sem ter bom senso para perceber que detalhes são importantes.

Experimenta isto

Quando uma conversa começa a ser comprimida, começa uma nova. Leva um resumo curto, não o histórico todo.

Publicação completa no

Fontes: Chroma, “Context Rot” (2025); NoLiMa, ICML 2025.

Carrossel
10×de diferença de preço em toda a gama Claude
#

Os modelos Claude explicados: Haiku, Sonnet, Opus ou Fable

TL;DR O Sonnet resolve a maior parte do trabalho. Baixa o nível de esforço antes de pagares por um modelo maior.

Haiku, Sonnet, Opus ou Fable? A maioria das equipas escolhe por intuição e paga a mais. Aqui fica a minha cábula.

  1. 💨 Haiku: rápido e barato. Triagem, etiquetagem, pequenas tarefas dentro de um agente maior
  2. ⚡ Sonnet: a escolha diária por defeito para programação e análise. Para a maioria dos produtos, o único modelo de que precisas
  3. 🧠 Opus: o que é difícil. Agentes de longa duração, grandes refatorações
  4. 🚀 Fable: o topo. Só quando o Opus já ficou aquém
Experimenta isto

Antes de passares para um modelo melhor: ativa o prompt caching, agrupa em lote o que pode esperar e só depois baixa o nível de esforço. É aí que está o dinheiro.

Publicação completa no
Vídeo
−39%de precisão quando as instruções chegam aos poucos
#

A tua IA não é tua amiga. Deixa de conversar com ela.

TL;DR Espalhar as instruções por várias mensagens reduziu a precisão em 39%. Põe tudo o que já sabes na primeira mensagem.

A tua IA não é tua amiga. Deixa de conversar com ela. A Microsoft e a Salesforce realizaram 200 000 conversas simuladas com 15 modelos. Instruções completas numa só mensagem tiveram 90/100. As mesmas instruções espalhadas por vários turnos, como numa conversa normal, tiveram 65.

Porquê? O modelo não espera. Adivinha o que ainda não disseste, responde cedo e depois defende essa suposição para sempre. A prova de que é uma questão de timing, e não de palavras: cola as mesmas peças numa só mensagem e recuperas 95% do desempenho total.

Experimenta isto

Não é “nunca faças perguntas de seguimento”. É “nunca o obrigues a adivinhar”. Tudo o que já sabes vai na primeira mensagem.

Publicação completa no

Fontes: Laban et al., ICLR 2026.

Carrossel
#

Deixa de tratar o Claude como um chatbot básico

TL;DR Skills que obrigam a uma especificação antes do código, a testes a sério e a depuração sistemática fazem avançar o trabalho de desenvolvimento a sério.

Se escreves prompts em bruto no Claude e esperas pelo melhor, estás a usar uma ferramenta elétrica como se fosse um martelo. O verdadeiro poder está nas skills: pequenos pacotes de instruções que ensinam o modelo a planear, testar e depurar de forma sistemática.

A minha stack obriga a uma especificação decente antes de qualquer código, introduz desenvolvimento orientado a testes a sério e até ensina o Claude a escrever novas skills para as minhas tarefas repetitivas.

Experimenta isto

Começa com uma skill: um passo de planeamento antes de cada tarefa maior. Acrescenta as outras quando esta pegar.

Publicação completa no
Vídeo
54%de precisão com a resposta enterrada a meio do prompt (56% sem documento nenhum)
#

A tua IA está a ler o teu prompt na diagonal

TL;DR Os modelos leem melhor o início e o fim dos prompts longos e perdem o meio. Põe o que importa no princípio e no fim.

A tua IA está a ler o teu prompt na diagonal. Stanford escondeu uma resposta no meio de 20 documentos e foi mudando a posição. No início: 76% certas. No fim: 63%. No meio: 54%. Pior do que não dar nada ao modelo.

“Mas isso é de 2023”, ouço-te dizer. Por isso fui verificar. Um estudo de 2025 mostrou que o enviesamento está embutido na forma como os modelos são construídos, não é um erro. As consultas simples melhoraram muito. As tarefas difíceis num muro de texto continuam a ser um problema.

Experimenta isto

O que é importante vai primeiro e por último. Nunca enterres o facto principal a meio de um texto colado e comprido.

Publicação completa no

Fontes: Liu et al., TACL 2023; Wu et al., ICML 2025; NoLiMa, ICML 2025.

Vídeo
#

O apocalipse da IA, ou um truque de relações públicas de mil milhões?

TL;DR “A nossa IA é perigosa demais” funciona como ótimo marketing e como argumento a favor de regras que sufocam os laboratórios mais pequenos.

Um investigador de IA saiu da Anthropic a avisar que estamos a correr em direção a uma superinteligência que nos pode aniquilar. O próprio responsável de alinhamento da Anthropic apontou um risco acima de 10%. Manchetes assustadoras por todo o lado.

A minha opinião: “a nossa tecnologia é perigosa demais” é o supremo exibicionismo. Diz aos investidores que o teu produto é mágico e empurra os governos para regras que só os maiores laboratórios conseguem pagar, o que sufoca os atores mais pequenos e de código aberto.

Estamos em perigo ou é marketing distópico? Provavelmente um pouco de ambos. Vale a pena perguntar sempre de onde vem o número.

Publicação completa no
Carrossel
#

5 conceitos de IA em linguagem simples

TL;DR Janelas de contexto, agentes, sistemas multiagente, MCP e modelos de raciocínio, explicados sem precisares de um curso de ciências da computação.

A IA avança tão depressa que só o jargão já te pode fazer sentir atrasada. Aqui ficam os cinco termos que importam agora, em linguagem simples. Sem precisares de um curso de ciências da computação.

  1. 💾 Janela de contexto: a memória de trabalho da IA
  2. 🤖 Agentes de IA: IA que faz mesmo o trabalho, não se limita a responder
  3. 🤝 Sistemas multiagente: dividir para conquistar
  4. 🔌 MCP: o adaptador universal que liga a IA às tuas ferramentas
  5. 🧠 Modelos de raciocínio: IA que pensa antes de falar
Experimenta isto

Guarda isto antes de o mundo da tecnologia inventar mais 14 siglas até amanhã de manhã.

Publicação completa no
Vídeo
#

Melhores resultados da IA vêm de um melhor processo

TL;DR Contexto, âmbito, plano, teste, verificação: uma rotina fixa de skills dá resultados mais estáveis do que um prompt engenhoso.

Melhores resultados da IA vêm de um melhor processo, não de um prompt mais engenhoso. Eu uso a mesma rotina de skills para qualquer tarefa maior e até troco de agente entre passos.

Porque funciona: menos aleatoriedade, um contexto limpo em cada passo e uma oportunidade para reveres pelo caminho. Corre no Claude Code, no Codex, no Cursor e no Gemini CLI.

  1. /context: fixa primeiro os factos
  2. /scope: escreve o que não é objetivo
  3. /plan: revê o plano, não o diff
  4. /test: verificável, não apenas plausível
  5. /verify: executa, não confies só
  6. /redteam: parte-o antes que os utilizadores o façam
Experimenta isto

Rouba um passo esta semana. Só o /scope evita muito crescimento silencioso de funcionalidades.

Publicação completa no
Vídeo
#

Faz sempre /plan antes de uma tarefa grande com IA

TL;DR Pede primeiro um plano à IA, corrige o plano e só depois deixa-a construir. O resultado é muito melhor.

AI maxxing, parte 1: antes de soltares a IA numa tarefa maior, obriga-a a planear.

No Claude ou no Codex, escreve o que queres e acrescenta /plan. Recebes um plano que podes ler, corrigir e aprovar antes de um único ficheiro ser alterado. Rever um plano leva dois minutos. Rever 500 linhas de código erradas leva uma tarde.

Experimenta isto

Próxima tarefa grande: /plan primeiro, depois constrói.

Publicação completa no
Vídeo
#

Não envies lixo de IA

TL;DR O resultado de IA não verificado limita-se a passar o trabalho para quem o lê. Nunca envies o que não saberias defender se te questionassem.

Já todos fizemos isto. Tarde, cansada, e o resultado da IA parece bom que chegue, por isso carregas em enviar.

Mas o lixo de IA não poupa tempo. Passa o trabalho para quem o lê e anula, em silêncio, o ganho de produtividade para toda a gente. (Se escorregares, ao menos tem um gato por perto a quem pôr as culpas.)

Experimenta isto

A minha regra: nunca enviar trabalho que não saberia defender se me questionassem. Se não o consigo explicar, não fui eu que o escrevi. Limitei-me a reencaminhá-lo.

Publicação completa no
Vídeo
51%das vezes a IA disse que não tinhas culpa (humanos: 0%)
#

A IA quer agradar a toda a gente, e alguém mediu isso

TL;DR Os chatbots dão-te razão cerca de 50% mais vezes do que as pessoas, e tu confias mais neles por causa disso. Pede primeiro o contra-argumento.

A IA quer agradar a toda a gente, e agora alguém mediu isso. Stanford e a CMU deram a 11 modelos publicações em que a comunidade tinha votado, por unanimidade, que quem escreveu estava errado. A IA disse que a pessoa não tinha culpa em metade dos casos.

O assustador é o que uma única conversa fez às pessoas: ficaram mais convencidas de que tinham razão, menos dispostas a resolver o conflito e confiaram mais no modelo. O chatbot que te impediu de pedir desculpa é o que classificaste como de confiança.

Experimenta isto

Antes de pedires a resposta, pergunta: “Qual é o argumento mais forte contra isto?”

Publicação completa no

Fontes: Cheng et al. (2026), Science.

Vídeo
106experiências na meta-análise
#

Não és melhor do que o modelo? Sai do circuito

TL;DR Em tarefas de decisão, humano e IA juntos tiveram pior desempenho sempre que a IA era melhor. Só intervém onde és melhor do que o modelo.

Humano mais IA deveria superar qualquer um dos dois sozinhos, certo? Uma meta-análise de 106 experiências na Nature Human Behaviour diz: muitas vezes não. Em tarefas de decisão, as equipas humano–IA foram piores do que o melhor dos dois.

A reviravolta está em quem é melhor. Quando o humano era melhor do que a IA, combinar ajudava. Quando a IA era melhor, acrescentar um humano piorava o resultado. Em trabalho criativo, como escrita e design, o efeito foi positivo, embora não significativo.

Experimenta isto

Antes de reveres o resultado da IA, pergunta-te com honestidade: sou melhor do que o modelo nesta tarefa em concreto?

Publicação completa no

Fontes: Vaccaro, Almaatouq & Malone (2024), Nature Human Behaviour.

Vídeo
#

Quantas IAs supervisionas ao mesmo tempo?

TL;DR O que te custa são as interrupções e a revisão constante, não o trabalho. Escreve uma linha sobre o ponto em que o agente está antes de mudares de tarefa.

Quantas IAs supervisionas ao mesmo tempo? Acumulam-se dois custos. As interrupções: numa experiência, as pessoas interrompidas relataram muito mais stress e frustração, sem cometerem mais erros. O custo recai sobre ti, não sobre o trabalho. E a revisão: verificar erros no resultado é, comprovadamente, difícil e stressante.

Correr três agentes significa pagar os dois, o dia inteiro.

Experimenta isto

Antes de largares um agente, escreve uma linha: onde ele está e o que vem a seguir. Menos resíduo de atenção, mais foco.

Publicação completa no

Fontes: Mark et al., CHI 2008; Warm et al., Human Factors 2008; Leroy & Glomb, 2018.

Vídeo
#

O teu cérebro está a subcontratar-se em silêncio

TL;DR Quanto mais a IA ajudava as pessoas a escrever, mais fraca era a sua própria atividade cerebral. Pensa durante 15 minutos antes de escreveres o prompt.

O MIT pôs pessoas com toucas de EEG a escrever ensaios: um grupo com IA, outro com um motor de pesquisa, outro sem nada. Quanto mais ajuda as pessoas tinham, mais fraca era a conectividade do cérebro. Muitas no grupo da IA não conseguiam citar uma única linha do ensaio que tinham acabado de terminar.

Ressalva honesta: é um preprint com 54 pessoas e já tem uma refutação. Acho que a direção está certa, mas não te agarres demasiado a isto. O problema não é a ferramenta. É a forma como a adotamos.

  1. 15 minutos: pensa tu primeiro no problema
  2. Faz primeiro um rascunho. Tópicos desarrumados contam
  3. Interroga o resultado. Não aceites, revê
Publicação completa no

Fontes: Kosmyna et al. (2025), preprint no arXiv.

Estás a trabalhar em algo nesta área? Vamos colaborar →
02

Diário de fundadora

Construir a Crocodata a par de um emprego a tempo inteiro: as horas de que ninguém fala, lições de outros fundadores, as decisões de design por trás do nosso site e das nossas apps, e as coisas que tive de desaprender.

5 histórias
Vídeo
#

4 lições para fundadores

TL;DR À mesa de mulheres fundadoras em Varsóvia: resolve o teu próprio problema, sê resiliente, aproveita a curva de aprendizagem íngreme e deixa a família inspirar-te.

Uma manhã, uma mesa, muitas mulheres a construir coisas reais. No Female Founders Breakfast, em Varsóvia, sentei-me entre uma marca de granola para crianças, uma app de IA para a saúde hormonal das mulheres e uma empresa que constrói casas de cânhamo e madeira. Saí de lá com quatro lições rabiscadas num guardanapo.

O fio condutor: todas as empresas fortes daquela mesa começaram com um problema que a fundadora tinha vivido na pele. Ninguém andava atrás de uma tendência.

  1. Resolve primeiro o teu próprio problema
  2. Sê resiliente e versátil: procura a oportunidade numa situação má
  3. Aproveita a curva de aprendizagem íngreme
  4. Deixa a tua família inspirar-te
Experimenta isto

Bónus da psicóloga que estava à mesa: fundar uma empresa muda a tua identidade. Prepara-te para a incerteza, não só para o produto.

Publicação completa no

Fontes: Female Founders Breakfast, Varsóvia, organizado pela Imaguru.

Publicação no LinkedIn
#

Deixei o Claude redesenhar o meu site

TL;DR Começa por uma imagem, não por um briefing, e compara opções antes de escrever código. Foi assim que este site deixou de parecer feito por IA.

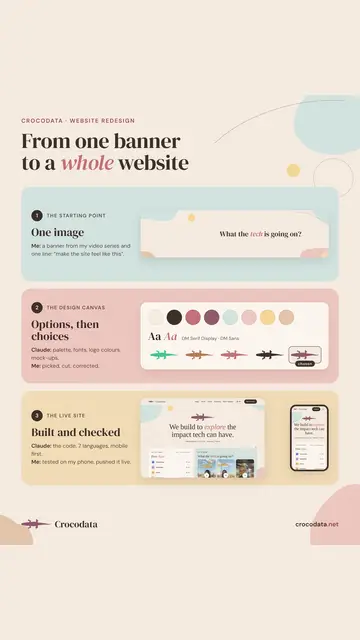
Estás a vê-lo agora. Este site foi redesenhado com o Claude, e a parte difícil não foi o código. Foi fazer com que não parecesse igual a todos os sites feitos por IA: o mesmo gradiente, os mesmos cartões arredondados, os mesmos tipos de letra.

O que funcionou: comecei por uma imagem, não por um briefing. Entreguei um banner da minha série de vídeos e disse: faz o site ter esta sensação. “Caloroso” ou “moderno” significa uma coisa diferente para cada pessoa. Uma imagem não.

Depois pedi opções antes de qualquer código. Uma tela de design com paletas, tipos de letra, o nosso logótipo de crocodilo em seis cores e maquetes da página inicial para computador e telemóvel. Comparei tudo lado a lado antes de mudar uma única linha do site.

Experimenta isto

Dá à IA uma imagem de referência e pede três direções lado a lado. Escolhe com os olhos e só depois deixa-a construir.

Publicação completa no
Carrossel
90dias que faltavam para o fim do ano quando publiquei isto
#

Faltam 90 dias para o fim do ano

TL;DR Não é razão para entrar em pânico, é razão para ser concreta: escolhe uma a três coisas que fariam o ano parecer completo e protege-as.

Faltam 90 dias para o fim do ano. Não é razão para entrar em pânico, é razão para ser concreta.

Entre a ciência de dados, o lançamento de apps independentes e a construção de um produto de legal tech, o quarto trimestre é quando decido o que realmente fica concluído este ano e o que, com honestidade, passa para o próximo. Acabaram-se os “começo em janeiro”.

Experimenta isto

Escolhe uma a três coisas que fariam o ano parecer completo. Protege o tempo para elas como se fosse um prazo inadiável.

Publicação completa no
Vídeo
20 000horas entre a ideia e o produto
#

De “tivemos uma ideia” a “construímo-lo”

TL;DR Entre a ideia e o produto lançado há cerca de 20 000 horas de trabalho duro de que ninguém gosta de falar.

Todas as histórias de startups saltam o meio. Há o momento do “tivemos uma ideia”, depois um corte, e depois o lançamento.

O corte são cerca de 20 000 horas de trabalho duro de que ninguém gosta de falar: os bugs à meia-noite, as rejeições das lojas de apps, o redesign que refazes três vezes. Esse meio é o trabalho. E é também onde está a maior parte da diversão, se deixares.

Publicação completa no
Carrossel
#

6 verdades que aprendi à bruta

TL;DR O sucesso não é proporcional ao esforço, trabalhar sem parar não é produzir, e os teus colegas não são a tua família.

A maior mentira da tecnologia e dos negócios: esforçares-te mais dá sempre melhores resultados. Entre projetos de dados e a construção de apps, tive de desaprender quase tudo o que pensava saber sobre o sucesso. Estas seis ainda me custam todos os dias.

  1. O sucesso não é proporcional ao esforço, e não é justo
  2. Diversifica a tua identidade e o teu rendimento; não ponhas 100% do teu valor próprio num só emprego
  3. Trabalhar sem parar não é produzir: as pausas fazem parte da qualidade
  4. Os teus colegas não são a tua família, diga o que disser a apresentação da cultura da empresa
  5. Deixa de te encolheres para caberes na sala
Experimenta isto

A número seis está na publicação. Qual é a que te custa mais? A minha é “deixa de te encolheres para caberes na sala”.

Publicação completa no
Estás a trabalhar em algo nesta área? Vamos colaborar →
03

Da universidade ao teu emprego

De um doutoramento em Física a cientista de dados na Google: candidaturas, entrevistas, mudanças de carreira e o que me manteve sã pelo caminho.

Terminei o doutoramento sem nenhuma oferta de emprego
Publicação no LinkedIn
~100candidaturas, a maioria terminada em rejeição
#

Terminei o doutoramento sem nenhuma oferta de emprego

TL;DR Quatro anos de física teórica, cerca de 100 candidaturas, quase todas rejeitadas. Depois, a Google. A procura faz parte da história.

Terminei o doutoramento sem nenhuma oferta de emprego. Quatro anos de física teórica na Sociedade Max Planck, em Berlim: teoria do funcional da densidade, dinâmica molecular, modelação de materiais átomo a átomo. A minha grande paixão.

Depois, seis meses em Stanford, em 2023. O Silicon Valley mesmo à porta, toda a gente a construir alguma coisa, e eu queria fazer parte dessa energia. Por isso, quando entreguei a tese, não fiquei na investigação. Comecei a candidatar-me.

Demorou meio ano e umas 100 candidaturas, a maioria com rejeição. Trading quantitativo, consultoria, ciência de dados. Depois a Google disse que sim. Se estás agora no meio dessa maratona: não é um veredicto sobre ti. É um jogo de números com uma cauda longa.

Experimenta isto

Acompanha as candidaturas como uma experiência: o que enviaste, o que voltou, o que vais mudar na ronda seguinte.

Publicação completa no
Carrossel
#

4 coisas que me mantiveram sã da universidade à Google

TL;DR Exercício, livros em papel, viagens e oito horas de sono. Tudo o resto é negociável.

Passar da universidade para a Google é um grande salto. Nova linguagem, novo ritmo, tudo novo. As pessoas perguntam como não entrei em burnout e, sinceramente, a resposta é aborrecida. Quatro hábitos, mantidos mesmo quando os prazos gritavam.

Tudo o resto na minha agenda é negociável. Estes quatro não são.

  1. Treinar, mesmo quando estou exausta
  2. Livros físicos: ecrãs o dia todo, papel à noite
  3. Viajar e explorar o mais que posso
  4. Pelo menos oito horas de sono, seja qual for o prazo
Experimenta isto

Escolhe o inegociável que largaste primeiro quando o trabalho apertou e volta a pô-lo na tua vida esta semana.

Publicação completa no
Vídeo
#

Como te destacares numa entrevista numa Big Tech

TL;DR Pede uma recomendação concreta e dedica 30 minutos aos projetos paralelos da empresa-mãe, não só à aplicação principal.

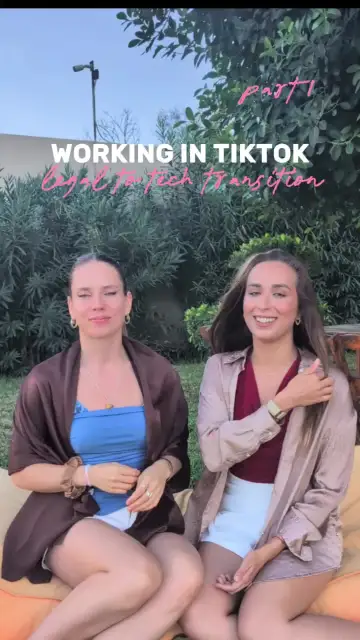
Parte 2 com a minha amiga Alex, Data Sovereignty Manager na equipa de engenharia de privacidade e segurança do TikTok, com a Activision Blizzard, a Microsoft e a Tencent no currículo. Perguntei-lhe o que faz realmente um candidato destacar-se.

As respostas dela foram refrescantemente concretas. Nenhuma é “faz mais LeetCode até à exaustão”.

  1. Consegue uma recomendação concreta: quem te recomenda deve descrever como trabalharam juntos e o que resolveste
  2. Dedica 30 minutos à empresa-mãe e aos seus projetos paralelos, não só à aplicação principal
  3. Leva uma mentalidade de Day 1: curiosa, pronta a resolver problemas, a importar-se com o produto
Experimenta isto

Antes da tua próxima entrevista, escreve uma coisa sobre o ecossistema da empresa que mais ninguém vai mencionar.

Publicação completa no
Vídeo
#

Do Direito a uma Big Tech: o que é realmente a soberania de dados

TL;DR A minha amiga Alex passou do direito da privacidade para a equipa de engenharia de privacidade do TikTok. Parte 1: como os conceitos jurídicos se transformam em trabalho de engenharia.

Dá para passar de um curso de Direito para uma equipa de engenharia? A minha amiga Alex conseguiu. Estudou direito societário, da privacidade e das TI e trabalha agora como Data Sovereignty Manager na equipa de Engenharia de Privacidade e Segurança do TikTok.

Na parte 1, falamos sobre o que significa realmente “soberania de dados” e sobre como os conceitos jurídicos se transformam em trabalho de engenharia a sério numa das maiores empresas tecnológicas do mundo. Fazer a ponte entre um percurso numa sociedade de advogados e uma equipa de ciências da computação é difícil. Ela prova que é possível.

Experimenta isto

Se és jurista e tens curiosidade pela tecnologia: as equipas de privacidade e segurança precisam de pessoas que falem as duas línguas.

Publicação completa no
Vídeo
#

Toda a ciência é ciência de dados

TL;DR Passar da física para a ciência de dados soube menos a recomeçar do zero e mais a trocar de instrumento.

Toda a ciência é ciência de dados. A única diferença é de onde vêm os dados.

Quando passei da física para a ciência de dados, soube menos a recomeçar do zero e mais a trocar de instrumento. As simulações passaram a ser registos de produto, os materiais passaram a ser utilizadores, e as perguntas ficaram as mesmas: o que é sinal, o que é ruído e quão certos estamos?

Experimenta isto

Cientistas: listem três coisas que fazem todas as semanas no laboratório. Agora reescrevam-nas em linguagem de ciência de dados. Esse é o vosso CV.

Publicação completa no
Carrossel
<1%a melhor pontuação de uma IA em jogos de puzzle novos em folha (humanos: 100%)
#

6 competências a desenvolver onde a IA ainda falha

TL;DR Problemas novos, experiência real, competências interpessoais, conhecimento profundo, gestão de agentes e resiliência: é aí que está o teu valor.

A IA está a melhorar depressa, mas continua a falhar em sítios previsíveis. É exatamente aí que está o teu valor. Investe aí.

  1. Problemas novos: a IA remistura o que já é conhecido
  2. Experiência real: os cargos juniores em empregos expostos à IA estão a diminuir, os experientes não
  3. Competências interpessoais: confiança e liderança não cabem num prompt
  4. Conhecimento profundo: logo além do alcance da IA, quem a usava errava mais vezes
  5. Gestão de agentes: rever o trabalho deles é o novo gargalo
  6. Resiliência: as ferramentas mudam de poucos em poucos meses
Experimenta isto

Escolhe uma competência da lista e treina-a de propósito este mês.

Publicação completa no
Vídeo
5rondas de entrevistas para uma vaga de ciência de dados na Google
#

Como me preparei para 5 entrevistas na Google com IA

TL;DR Mapeia os temas, escreve um documento-mestre e depois deixa uma IA entrevistar-te em voz alta até deixar de encontrar lacunas.

A Google deu-me cinco entrevistas: três sobre estatística e intuição de dados, uma de programação, uma de Googleyness. Preparei-me para todas com IA, e aqui fica exatamente como.

O segredo não foi um curso mágico. Foi transformar a IA numa entrevistadora que nunca se cansa de fazer perguntas de seguimento.

  1. Mapeia os temas: testes A/B, sentido de produto, estatística, probabilidade, inferência causal
  2. Escreve um documento-mestre com todos os conceitos
  3. Dá o documento a uma IA e deixa-a entrevistar-te em voz alta
  4. Trata o entrevistador como um amigo colaborativo: as perguntas são abertas, não existe resposta perfeita
Experimenta isto

Comenta “DATA SCIENCE” por baixo da publicação e envio-te o meu documento de preparação.

Publicação completa no
Vídeo
#

O meu caminho da universidade à Google

TL;DR Química, ciência dos materiais, física e depois a tecnologia, porque é onde a mudança está a acontecer neste momento.

Estudei química, depois ciência dos materiais, depois física, porque era apaixonada por ciência. A certa altura reparei onde a mudança estava realmente a acontecer: na tecnologia.

Por isso segui-a. Esta é a versão curta de como uma pessoa de laboratório foi parar à Google, e porque não vejo isso, de todo, como abandonar a ciência.

Publicação completa no
Estás a trabalhar em algo nesta área? Vamos colaborar →
Trabalhemos juntos

Tens uma história que as provas deviam contar?

Estou aberta a colaborações com investigadores, fundadores, criadores de ferramentas e outros criadores, desde que haja algo real para analisar.

01

Explica a tua investigação

Um artigo ou conjunto de dados que queres que pessoas de fora da tua área compreendam. Transformo-o num vídeo e numa história que mantêm as ressalvas.

02

Conversa com convidado

Uma mudança de carreira ou uma profissão que as pessoas entendem mal, como a entrevista do Direito para o TikTok. Curta, honesta, útil.

03

Palestras & mentoria

Hackathons, meetups, grupos universitários: IA na prática, carreiras em ciência de dados, o salto do doutoramento para a indústria.

04

Constrói com a Crocodata

Uma app ou ferramenta que queres mesmo que exista. Construímos as nossas e estamos abertos a construir a tua.